
⚠️ Certains passages abordent des détails techniques approfondis. Le symbole ⚠️ signale des paragraphes ou des sections facultatifs. Vous pouvez les passer si vous préférez une explication générale, sans perdre le fil de l’argument.
Introduction
Un logiciel peut sembler finalisé bien avant que son comportement en conditions difficiles ne soit établi. Les outils d'IA permettent de développer rapidement des interfaces et des fonctionnalités, mais une démonstration ne teste que les scénarios sélectionnés. Elle ne renseigne guère sur la réaction du logiciel face à une requête provenant d'un compte incorrect, sur le risque de dysfonctionnement grave lié à un fichier corrompu, ou encore sur les risques de fuite d'informations suite à une dépendance défaillante. Démontrer un comportement utile et définir des limites fiables exige des preuves d'un autre ordre.
Un système doit faire respecter ses limites malgré les instructions erronées, les identifiants volés, les changements d'état et les tentatives délibérées de le faire dysfonctionner. Ces limites s'étendent au-delà des fonctionnalités visibles de l'application et englobent les systèmes d'identité, les services privilégiés, les bibliothèques, les systèmes d'exploitation, le matériel et la maintenance. Chaque composant peut sembler fonctionner correctement, mais une erreur de décision entre eux peut entraîner des conséquences néfastes.
La sécurité est généralement abordée sous l'angle de la confidentialité, de l'intégrité et de la disponibilité : empêcher la divulgation non autorisée, empêcher toute modification non autorisée et garantir l'utilisation des services dans des conditions définies. Ces termes désignent des résultats, et non des mesures de protection. Un dossier médical, un solde bancaire et un horaire de transport sont chacun soumis à des règles et à des conséquences différentes. Le travail commence par l'identification des éléments à protéger, des actions susceptibles d'enfreindre ces exigences et des conséquences que pourraient avoir ces actions. La collecte et la conservation d'informations moins sensibles peuvent également atténuer les conséquences d'une violation ultérieure, même lorsque les contrôles d'accès sont par ailleurs rigoureux. [1]
Un contrôle de sécurité n'est efficace que dans la mesure où il s'applique aux opérations qu'il régit. Un site web peut bloquer un téléchargement non autorisé tandis qu'une fonction d'exportation autorise le même fichier. Le chiffrement peut protéger un fichier alors que sa clé de déchiffrement est accessible à une personne non autorisée. Une application peut autoriser un fichier puis en ouvrir un autre sous le même nom. Dans chaque cas, une protection locale peut laisser croire que l'opération est entièrement protégée alors qu'elle ne l'est pas.
Un modèle de menaces identifie les éléments à protéger, les modifications qu'un attaquant peut apporter, les lieux où se produisent les décisions privilégiées et les hypothèses susceptibles de s'avérer erronées. Il permet de mettre en évidence les vecteurs d'attaque potentiels sans prétendre prédire toutes les attaques. [2]
L'identification de ces voies d'accès révèle également la surface d'attaque du système : les points d'entrée potentiels pour un attaquant, tels que les entrées, les requêtes ou les informations. Les services réseau, les interfaces de connexion et d'administration, ainsi que les fonctions d'importation de fichiers constituent autant de points d'entrée possibles, même lorsqu'ils ne sont pas immédiatement visibles. Réduire cette surface implique de désactiver les fonctions et services superflus, de limiter l'accès aux éléments restants et de refuser les autorisations inutiles. Un nombre réduit de voies d'accès exposées diminue les risques d'attaque, mais les voies restantes nécessitent néanmoins une surveillance et une maintenance rigoureuses.
Là où la sécurité échoue en premier
De nombreux incidents graves ne nécessitent aucune technique extraordinaire. Des comptes existent toujours avec des mots de passe fournis par le fabricant, partagés entre utilisateurs ou réutilisés sur différents services. Une fois qu'un attaquant s'empare d'un tel mot de passe, le système peut accepter la connexion sans problème. Les tentatives de devinettes de mots de passe, les attaques automatisées utilisant des identifiants divulgués et les demandes frauduleuses de codes à usage unique exploitent les failles liées à l'identité plutôt que les erreurs du code de vérification des mots de passe. Des identifiants uniques et difficiles à deviner, une récupération de compte fiable, des limitations de débit et des méthodes de connexion plus robustes peuvent réduire ces risques. L'authentification multifacteurs et les clés d'accès offrent une protection importante, mais aucune méthode de connexion ne peut déterminer de manière indépendante si une instruction émise après la connexion est pertinente ou légitime. [3] [4]
Il arrive que l'on oublie son mot de passe ou que l'on perde l'appareil utilisé pour se connecter. Un service doit permettre de récupérer l'accès au compte, tout en distinguant le titulaire légitime d'une personne tentant de s'en emparer. Si la réinitialisation de l'accès ne requiert que des informations facilement accessibles, un imposteur peut contourner même les protections de connexion les plus robustes. La récupération de compte doit donc offrir une solution pratique aux utilisateurs légitimes sans faciliter la tâche aux pirates.
Se connecter n'est que le point de départ de la protection d'un compte. Pour éviter d'exiger un mot de passe ou une clé d'accès pour chaque action, de nombreux services attribuent un identifiant de session ou un jeton d'accès qui représente une session authentifiée. Si un attaquant obtient un identifiant réutilisable de ce type, le service peut accepter des requêtes en se faisant passer pour le compte connecté, sans exiger à nouveau les facteurs d'authentification initiaux. C'est ce qu'on appelle le détournement de session. La sécurité dépend donc de la manière dont les sessions sont émises, stockées, limitées, expirées et révoquées, notamment après une suspicion de compromission ou de récupération de compte. La protection de la connexion et la protection des droits d'accès conservés après la connexion sont deux responsabilités distinctes. [5]
L'ingénierie sociale exploite le facteur humain dans la prise de décision. Un message peut prétendre qu'un fournisseur a modifié ses coordonnées bancaires, qu'un compte doit être vérifié d'urgence ou qu'un document est requis après connexion. Le lien malveillant peut mener à une imitation convaincante d'un service légitime, ou un téléchargement peut tenter d'exploiter une application vulnérable. Ouvrir une adresse web ne signifie pas pour autant céder un compte ou infecter un ordinateur : le résultat dépend de la destination, du navigateur et des protections de l'appareil, de la version du logiciel et des actions ultérieures. La distinction essentielle réside entre une page reçue via une connexion sécurisée et la fiabilité de cette page. Le chiffrement protège les données en transit vers le site consulté ; il ne permet pas de garantir que ce site est bien celui que l'utilisateur souhaitait visiter. [3]
L’hameçonnage ne se résume pas à tester la capacité d’une personne à reconnaître un message suspect. L’étude SoK de Zhuo et ses collègues (2023) a analysé 52 études empiriques et classé les facteurs de vulnérabilité en fonction des caractéristiques individuelles, du contexte et des circonstances de réception du message. Cette synthèse ne permet pas d’établir un profil type des personnes susceptibles d’être trompées. La protection repose donc sur une authentification appropriée, une conception d’interface adaptée, des procédures de confirmation pour les instructions importantes et une formation, plutôt que de s’appuyer uniquement sur la vigilance. [6]
La configuration peut exposer inutilement un système ou limiter les possibilités d'accès d'un attaquant. Un dossier destiné à une équipe peut être laissé public, une interface de gestion accessible depuis Internet alors qu'elle devrait être interne, une base de données peut conserver des identifiants par défaut, ou un environnement de test peut contenir des données réelles avec des restrictions moins strictes. Il s'agit là d'erreurs de configuration : le logiciel peut se comporter comme prévu, mais ses paramètres autorisent des accès ou des opérations non prévus. Les valeurs par défaut non sécurisées, les paramètres copiés et les exceptions accumulées contribuent tous à ce risque.
Une configuration délibérée peut en revanche réduire la surface d'attaque. C'est ce qu'on appelle le renforcement de la sécurité : activer uniquement les services et fonctionnalités nécessaires, restreindre leur accès et vérifier l'efficacité de ces restrictions. Un service SSH utilisé pour administrer un serveur à distance, par exemple, peut être limité aux comptes autorisés et aux chemins réseau approuvés, configuré pour interdire la connexion directe en tant que root sur les systèmes de type Unix et, le cas échéant, utiliser une authentification par clé plutôt que par mot de passe. Si l'administration à distance n'est pas nécessaire, SSH peut être complètement désactivé. Ces mesures suppriment ou restreignent les moyens d'accéder au service, mais ne garantissent pas que le reste du code est exempt de vulnérabilités. Le renforcement de la sécurité doit également préserver les accès légitimes et être vérifié sur le système déployé. [4]
Les identifiants sont plus vastes que les mots de passe. Les services logiciels utilisent des clés secrètes et des jetons d'accès pour communiquer entre eux, et les employés ou les sous-traitants peuvent disposer de comptes d'administrateur dotés de pouvoirs étendus. Une clé publiée accidentellement dans un dépôt de code, incluse dans un journal ou conservée après la fin d'un contrat avec un fournisseur peut donner accès sans même tenter de casser le chiffrement. Le chiffrement ne peut empêcher la divulgation si un attaquant obtient la clé de déchiffrement nécessaire ou contrôle un service autorisé à révéler le texte clair. La protection des informations stockées dépend donc de la gestion des clés et de l'accès au déchiffrement, et pas seulement de l'algorithme. Une organisation peut également accorder à son personnel des droits d'accès bien plus étendus que nécessaire. La réponse appropriée consiste à contrôler le stockage des identifiants, à limiter leur portée, à les retirer lorsqu'ils ne sont plus nécessaires et à être en mesure d'identifier toute utilisation suspecte. Les journaux peuvent aider à établir les faits, mais la journalisation seule ne peut empêcher les abus et peut introduire des informations sensibles si elle est mal conçue. Le problème sous-jacent est le même qu'avec les mots de passe par défaut : un identifiant techniquement valide peut conférer des pouvoirs bien au-delà de l'usage prévu. [2]
Ces cas ont un point commun important : une authentification acceptée, un message plausible ou un paramètre permissif peuvent entraîner une action non autorisée. Protéger cette décision implique plus qu’un simple avertissement. Les services peuvent limiter les conjectures, rendre les autorisations à haut risque exceptionnelles et fournir une confirmation indépendante pour les modifications importantes. Une autre difficulté consiste à garantir que ces contrôles régissent le fonctionnement réel, notamment lorsqu’un composant plus puissant agit pour le compte d’un tiers.
Identité, autorisation et autorité déléguée
L'authentification détermine le compte ou l'identité à l'origine d'une requête. L'autorisation définit les actions que cette identité peut entreprendre sur un enregistrement ou une opération. Un employé peut être correctement connecté sans pour autant avoir le droit de consulter les fichiers d'un autre employé. Connaître un numéro d'enregistrement ou posséder un lien ne constitue pas, en soi, une autorisation de récupérer l'enregistrement. Un système qui masque un bouton d'exportation tout en laissant une interface sous-jacente permettant d'exporter les mêmes informations protège l'interface plutôt que l'opération. Chaque voie pertinente, y compris les requêtes directes, les tâches en arrière-plan et les services internes, doit acheminer la décision d'autorisation nécessaire jusqu'au point où l'effet protégé se produit. [7]
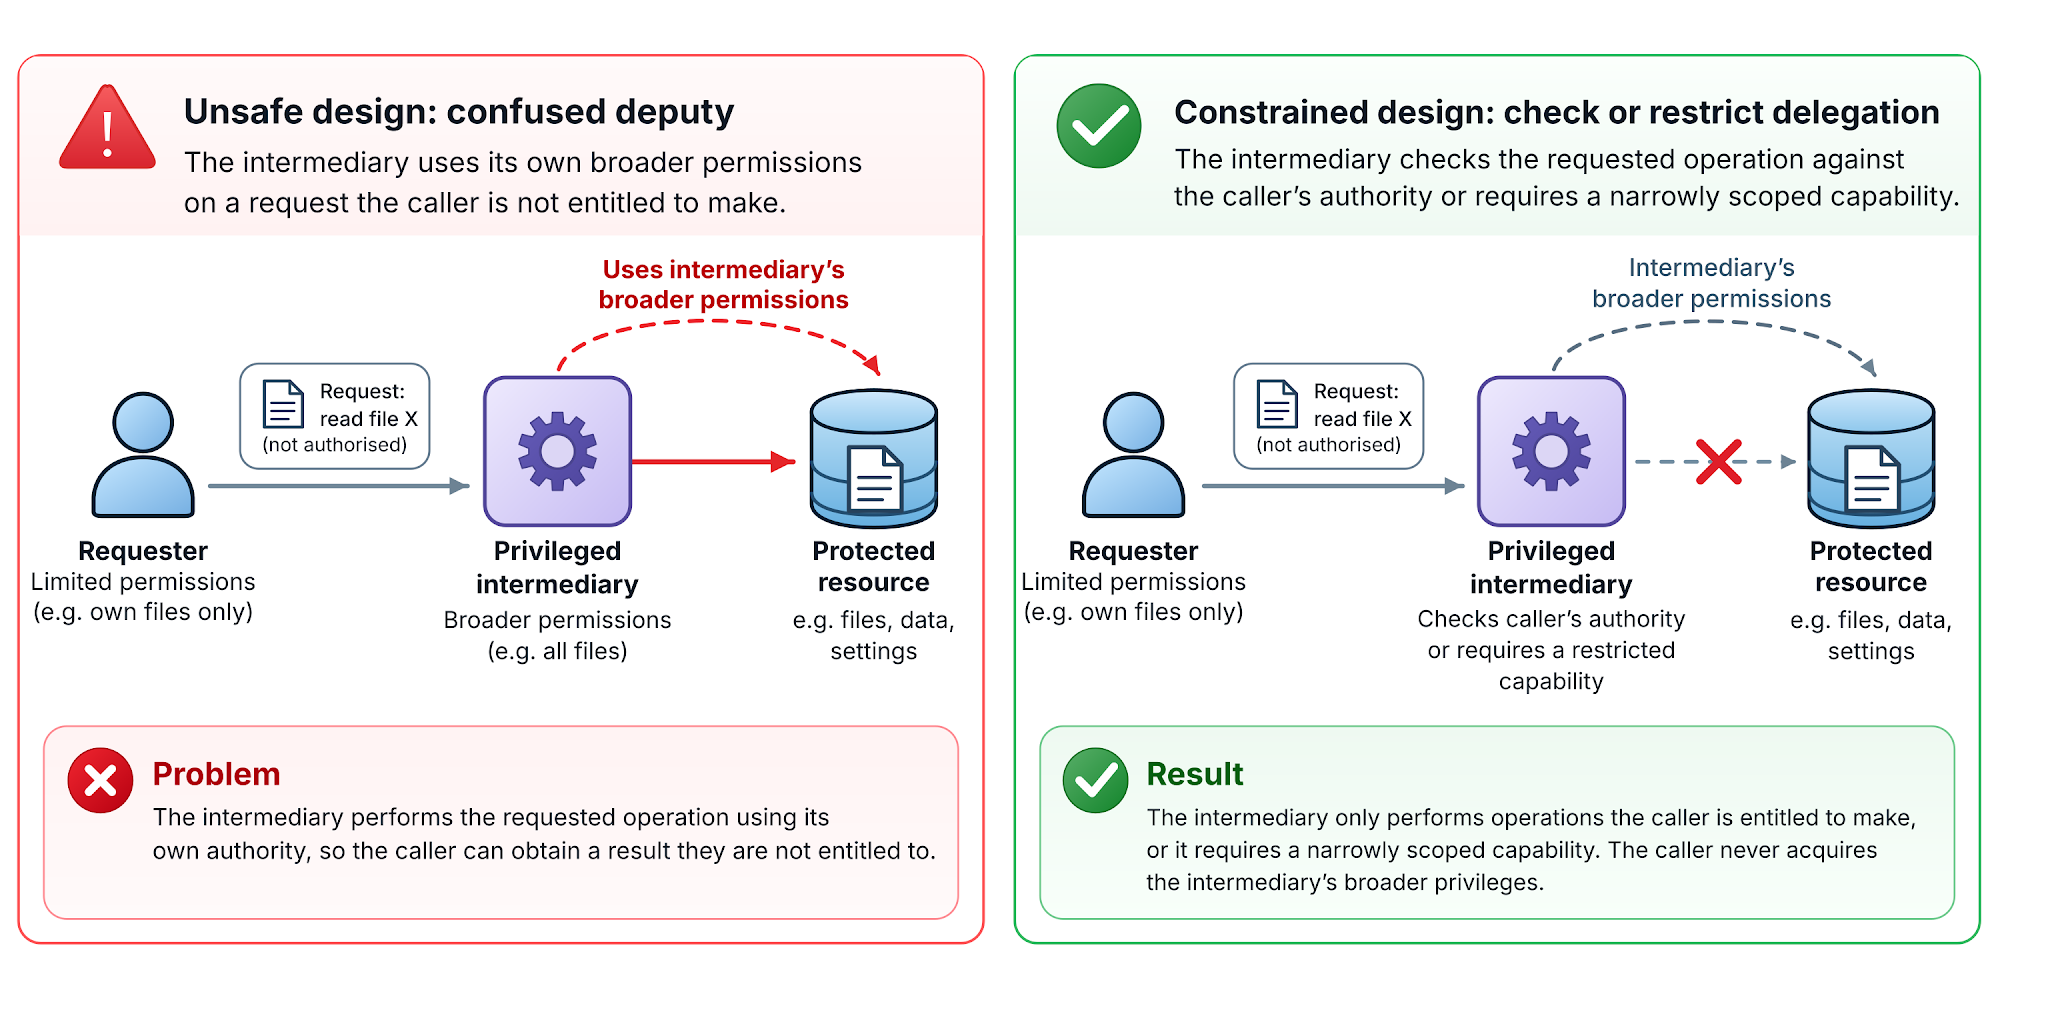
Le problème de l’intermédiaire privilégié dont les droits sont détournés (confused deputy) survient lorsqu'un logiciel utilise ses propres autorisations étendues pour exécuter une requête à laquelle l'appelant n'est pas autorisé à accéder. Par exemple, un service d'archivage peut être autorisé à consulter tous les fichiers, alors qu'un utilisateur ordinaire ne devrait accéder qu'aux siens. Si le service accepte n'importe quel identifiant d'enregistrement sans vérifier les droits de l'appelant, il risque de renvoyer les informations d'une autre personne. L'utilisateur n'acquiert jamais les autorisations globales du service ; ce dernier les utilise abusivement pour le compte de l'utilisateur. Isoler les enregistrements protégés est donc insuffisant si un intermédiaire privilégié peut les récupérer pour toute personne qui en fait la demande. [8]
Une interface de délégation robuste restreint les tâches que le composant privilégié accepte d'effectuer. Plutôt que d'accepter un chemin d'accès à un fichier sans restriction, elle peut accepter une opération spécifique autorisée, liée aux droits de l'appelant, ou une capacité limitée prouvant l'autorité sur une ressource particulière. Il s'agit d'une application du principe du moindre privilège : les comptes, composants et services ne reçoivent que les accès et opérations requis par leurs fonctions. Cela limite également l'impact d'une erreur, c'est-à-dire les informations et actions qu'une défaillance peut affecter, y compris par le biais d'autres composants disposés à agir en son nom. Un composant peut ne pas avoir d'accès direct à des fichiers privés et pourtant les exposer indirectement via un service plus puissant si ses requêtes ne sont pas suffisamment encadrées. [9] [10]
L'autorisation ne peut être établie uniquement par une identité technique. Un employé légitime peut recevoir des instructions frauduleuses pour modifier ses coordonnées bancaires, et un administrateur légitime peut approuver une configuration dangereuse. Le système informatique peut authentifier correctement le compte de l'employé sans pour autant avoir de raison de se fier à l'origine déclarée de la demande. Pour les modifications importantes, la confirmation par des coordonnées de contact établies indépendamment permet de s'assurer que l'instruction provient bien de la personne concernée. Ces procédures contribuent à lutter contre les instructions frauduleuses, mais ne pallient pas l'absence de contrôle d'autorisation au sein de l'application. Chaque vulnérabilité requiert une protection adaptée.
Un autre danger réside dans l'utilisation abusive et délibérée d'un accès légitimement accordé. Une personne peut être correctement connectée et autorisée à consulter des documents sensibles, mais néanmoins les divulguer à un tiers non autorisé ou utiliser des fonctions d'administration à des fins malveillantes. L'authentification et l'autorisation peuvent fonctionner comme prévu ; elles ne permettent pas d'établir les intentions d'une personne. Des autorisations restreintes, la séparation des tâches sensibles, la tenue de registres appropriés des actions consécutives et un contrôle indépendant peuvent limiter ou déceler ce type d'abus interne. [11]
L'autorisation d'effectuer une opération ne garantit pas sa validité à chaque étape d'un processus plus vaste. Une commande ne doit pas être traitée avant que les conditions de paiement requises ne soient remplies. Un bon d'achat à usage unique ne doit pas être utilisé de manière répétée sous prétexte que chaque demande est correcte et provient d'un compte éligible. Il s'agit là de défaillances de la logique métier : l'application n'a pas appliqué les prérequis, la séquence de validité ni les limites régissant les actions associées. Ces règles doivent être vérifiées par rapport à l'état de référence lors de la transition consécutive, et non déduites d'un écran affiché ou d'une étape déclarée par le demandeur. Cette faille peut exister sans situation de concurrence, commande malveillante ni compte volé. [12]
Lorsqu'une vérification correcte ne s'applique plus
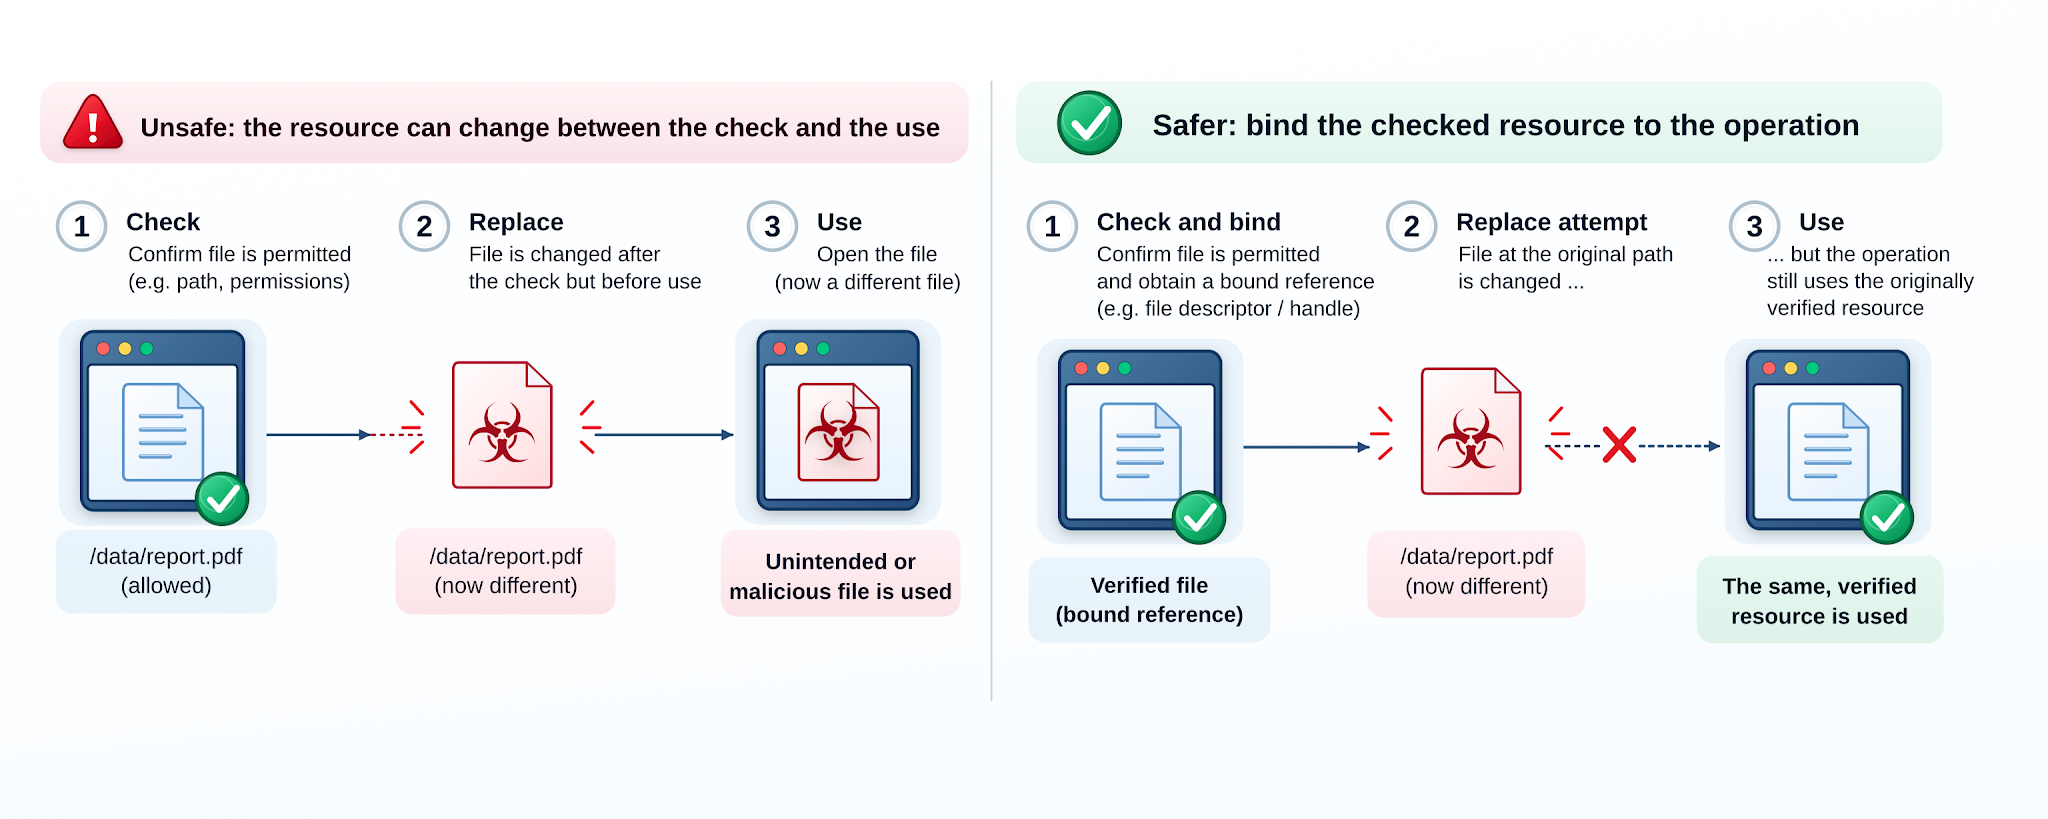
Une vérification d'autorisation peut être correcte au moment de son exécution et pourtant ne plus protéger une action ultérieure. Un fichier peut être approuvé puis remplacé avant même que le programme ne l'ouvre. Deux processus peuvent chacun constater la disponibilité suffisante de ressources et les consommer simultanément. Il s'agit de problèmes liés à l'écart entre la vérification et l'utilisation (TOCTOU) : l'état inspecté n'est plus celui sur lequel s'applique l'opération qui en découle. Ces problèmes deviennent des failles de sécurité lorsqu'un tiers peut exploiter cet écart pour enfreindre une règle requise. Certains résultent d'opérations concurrentes ; d'autres concernent des ressources dont l'identité ou les autorisations changent en cours d'exécution. [13]
Prenons l'exemple d'un programme qui vérifie le chemin d'accès d'un fichier par rapport à un emplacement autorisé, puis ouvre ce chemin ultérieurement. Si un attaquant parvient à modifier le nom du chemin entre-temps, le programme risque de traiter un fichier différent de celui qu'il a autorisé. La solution consiste à appliquer la décision à la ressource et à l'état réellement utilisés. Selon le système, cela peut impliquer d'opérer sur un descripteur de fichier déjà ouvert et vérifié, d'utiliser une opération atomique ou une transaction, de détenir un verrou approprié, ou de définir comment la révocation affecte le travail déjà commencé. Répéter une vérification sans combler l'intervalle suivant n'offre aucune garantie.
La concurrence engendre des défaillances connexes, au-delà de la simple gestion des accès aux fichiers. Plusieurs requêtes individuellement valides peuvent, collectivement, dépasser la limite d'un compte si elles sont comparées à un état obsolète. Un privilège peut être révoqué pendant l'exécution d'une tâche de longue durée, ou un identifiant peut être réattribué alors qu'un autre composant suppose qu'il se réfère toujours au même objet. Une conception sécurisée doit spécifier quel état fait foi et comment la vérification et l'opération qui en découle restent cohérentes.
Lorsque l'information permet d'orienter le travail
Les programmes traitent les données fournies par les requêtes des utilisateurs, les fichiers importés, les messages réseau et d'autres services. Une valeur peut être correctement formée et pourtant inadaptée à l'opération qu'elle contrôle. Un nom de fichier peut mener en dehors du dossier prévu. Un identifiant d'enregistrement peut désigner les données d'une autre personne. Un petit fichier compressé peut exiger énormément de travail lors de sa décompression. Qualifier ces données d'entrées non fiables signifie que les propriétés nécessaires à leur utilisation particulière n'ont pas encore été établies. Cela ne signifie pas que tout expéditeur est malveillant. La même faille peut résulter d'une manipulation délibérée, d'un fichier corrompu ou d'une simple erreur. [14]
Une transition dangereuse se produit lorsque des données sont transformées en instruction. Une requête de base de données ou une commande système, construite en associant du texte de programme à une valeur externe, peut permettre à cette valeur de modifier la commande elle-même. Il s'agit d'une vulnérabilité d'injection. Une page web peut présenter un dysfonctionnement similaire lorsqu'un texte externe est intégré à un contenu que le navigateur interprète comme du code au lieu de l'afficher comme du texte. C'est une attaque XSS (Cross-Site Scripting) ; pour s'en prémunir, il est nécessaire de gérer le contenu en fonction du contexte spécifique dans lequel le navigateur l'interprétera. Les interfaces plus sûres séparent l'opération prévue des données variables, par exemple en utilisant des requêtes de base de données paramétrées lorsque l'interface les prend en charge. La solution ne consiste pas en une liste générique de caractères suspects : une valeur sûre en tant que texte brut peut devenir dangereuse lorsqu'elle est interprétée comme une commande, un chemin de fichier ou une partie d'un autre langage. Même une requête de base de données correctement construite nécessite une vérification distincte afin de s'assurer que le demandeur est autorisé à obtenir son résultat. [15] [16]
Certaines entrées malveillantes ne contiennent aucune commande. Un décodeur multimédia peut être sollicité pour allouer plus de mémoire que prévu, un document complexe peut consommer un temps de traitement excessif et des requêtes autorisées répétées peuvent surcharger un service partagé. Les limites de ressources doivent être appliquées avant et pendant les opérations coûteuses, et non après que le coût a déjà été engagé. La défaillance qui en résulte peut se traduire par un refus contrôlé, un plantage ou une indisponibilité du service pour les autres utilisateurs. C'est pourquoi la sécurité concerne également la capacité des systèmes à continuer d'exécuter leurs tâches légitimes. Les conditions dans lesquelles un service garantit sa disponibilité, ainsi que les limites de cette garantie, méritent autant de précision que ses règles d'accès. [14]
Ces défaillances diffèrent selon le point de rupture de la communication entre des informations non fiables. Parfois, elles sont interprétées comme une instruction, parfois elles épuisent une ressource, et parfois elles sont traitées par un code incapable de gérer sa propre mémoire en toute sécurité. Ce dernier cas mérite une attention particulière, car un fichier ou un message malformé peut exploiter la manière dont un programme stocke et accède aux données, même lorsque l'entrée ne contient aucune commande.
Sûreté de la mémoire et garanties des langages
Tout programme en cours d'exécution nécessite un espace de travail, appelé mémoire. Le programme place des valeurs dans des zones qui lui sont réservées, les utilise, puis libère l'espace mémoire devenu inutilisé. Une exigence fondamentale est qu'une opération ne doit pas lire ni écrire en dehors de la zone qui lui est allouée. Une autre est que l'espace de stockage ne doit pas continuer à être utilisé comme s'il appartenait à un objet après la fin de la durée de vie de ce dernier. Ces deux protections sont essentielles à la sécurité de la mémoire. Elles concernent la validité des opérations mémoire, et non la question de savoir si une personne était autorisée à les effectuer.
L'analogie avec le système de classement (voir « Comment fonctionnent les ordinateurs : le système de classement ultrarapide de Feynman ») est pertinente. Un tiroir de classement peut contenir 100 fiches, mais une instruction exige l'insertion de 120 fiches. Sans règle limitant la capacité du tiroir, les fiches supplémentaires risquent d'être placées à la place d'autres documents. Dans un ordinateur, une écriture non contrôlée au-delà d'une zone allouée peut corrompre des données non liées ; une lecture non contrôlée peut exposer des informations provenant d'une autre zone. Selon le programme et les protections en place, les conséquences peuvent aller d'un plantage ou d'un résultat incorrect à une vulnérabilité exploitable par un attaquant. Une opération contrôlée, en revanche, empêche l'accès invalide. La tâche de classement demandée peut échouer, mais cette limite spécifique est préservée. Les fiches sont une métaphore des emplacements mémoire, et non une affirmation selon laquelle tout dépassement donne automatiquement le contrôle à un attaquant.
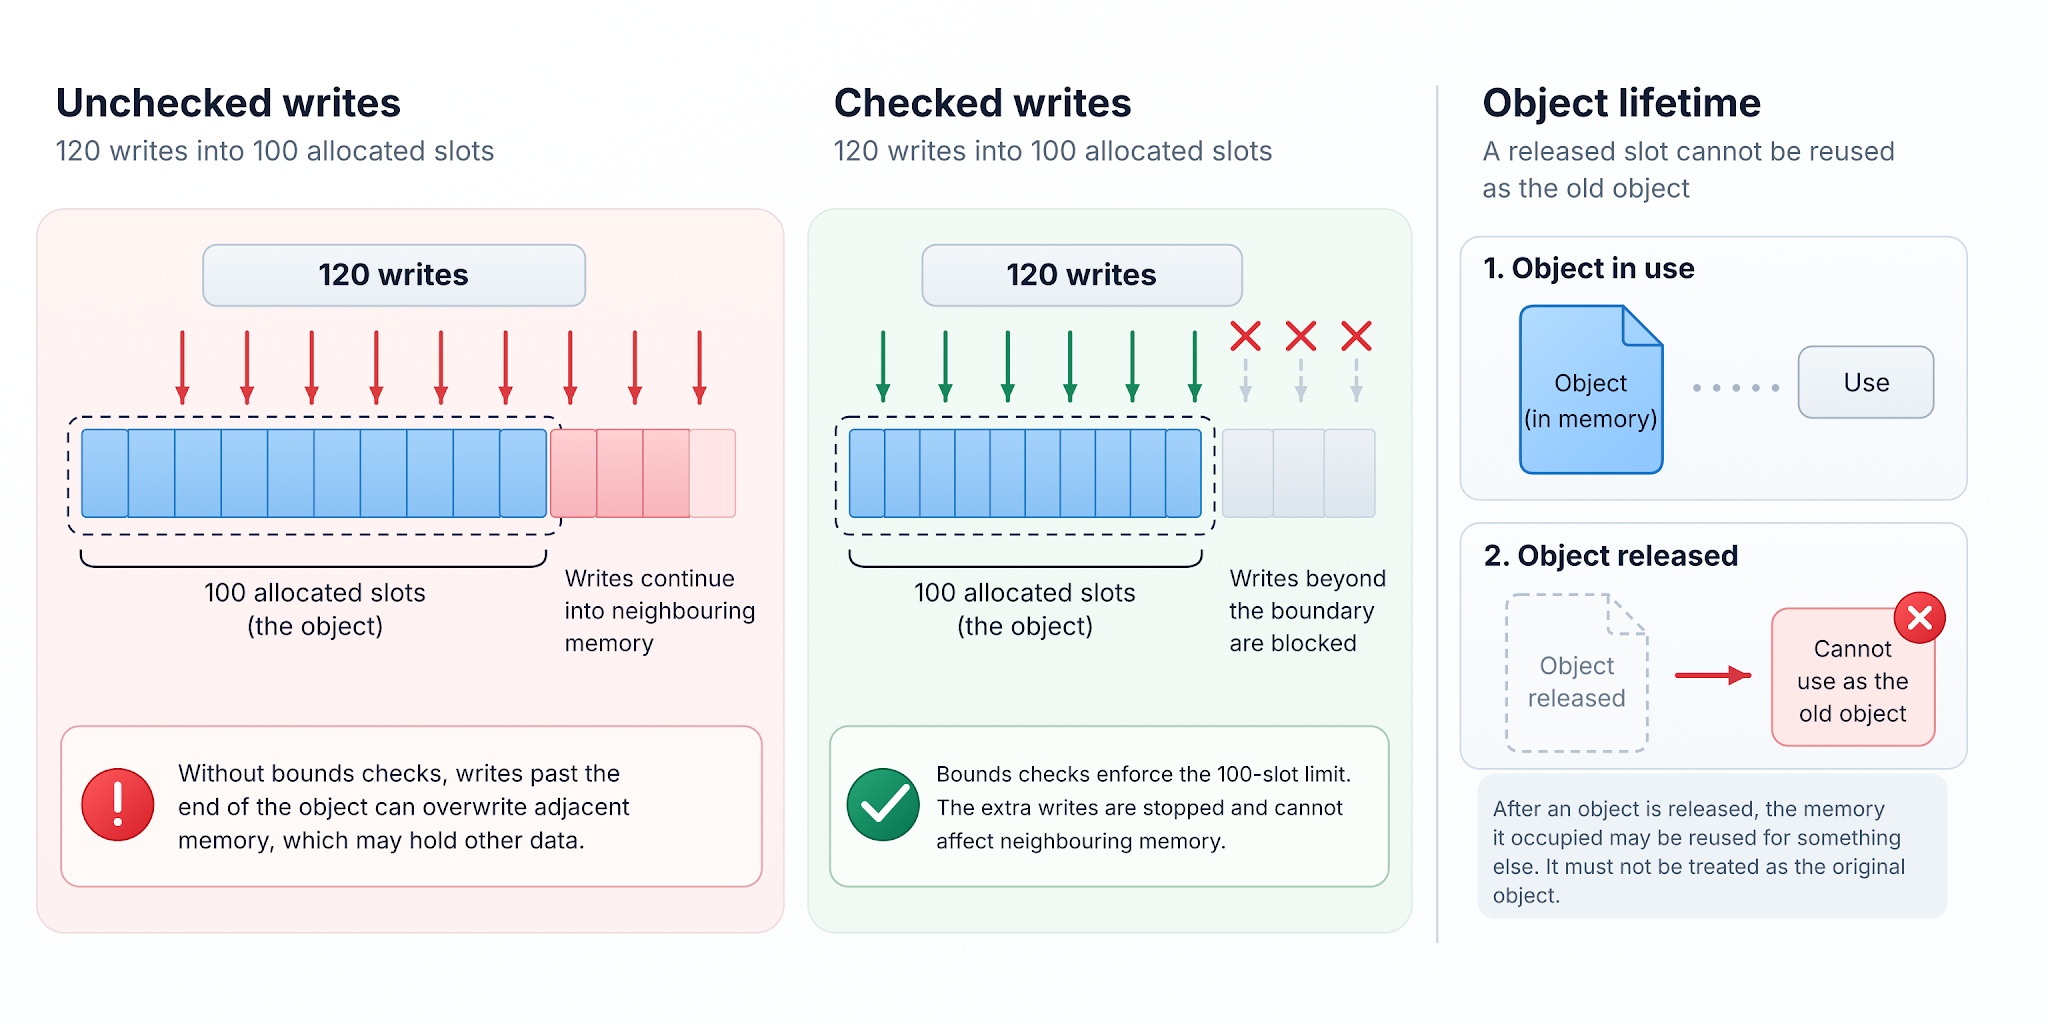
Une autre erreur de mémoire survient lorsqu'un programme conserve une référence à un objet après la libération de son espace mémoire. Si cette même zone est ensuite réutilisée pour un autre objet, la référence obsolète risque de lire ou d'écraser des informations non pertinentes. Il s'agit d'une erreur d'utilisation après libération. Un simple contrôle des limites ne suffit pas à valider l'accès : l'adresse peut se situer dans une zone allouée, mais l'objet qui justifiait initialement la référence n'existe plus. Les protections spatiales et de durée de vie permettent de gérer différents types de défaillances.
Les langages système anciens et largement utilisés, tels que C et C++, permettent certaines manipulations directes de la mémoire, pour lesquelles le programmeur doit définir les limites et les règles de durée de vie nécessaires. Ce contrôle a permis le développement de logiciels importants, mais les erreurs commises sur des chemins non sécurisés peuvent être graves et difficiles à détecter. Une implémentation rigoureuse, la revue de code, l'analyse automatisée, les options de compilation protectrices et les tests réduisent les risques ; ils ne rendent cependant pas toute exécution sûre par définition. De même, la présence de C ou de C++ dans un produit ne prouve pas que ce dernier est vulnérable. Les questions pertinentes concernent le code spécifique qui traite les entrées concernées, les vérifications ou protections qu'il utilise et les mécanismes dont il dispose en cas d'erreur.
Les langages à sécurité mémoire délèguent une partie de la responsabilité aux règles appliquées par le langage ou son environnement d'exécution. Rust sécurisé rejette de nombreuses références invalides avant l'exécution d'un programme et vérifie les accès indexés selon les besoins. Les mécanismes de sécurité Swift classiques imposent des limites et des contraintes de durée de vie gérées. Le code d'une application Python opère généralement sur des objets gérés plutôt que d'effectuer des opérations arithmétiques directes sur les pointeurs. Ces langages ne dispensent pas de prendre des décisions de sécurité appropriées, et leurs protections ne s'étendent pas nécessairement à tous les composants natifs. Rust comporte des régions explicitement non sécurisées ; Swift peut appeler des bibliothèques C ou utiliser des pointeurs non sécurisés ; Python peut charger des extensions natives. Une application à sécurité mémoire qui transmet des données à du code non sécurisé hérite de la nécessité d'examiner cette limite et le code qui la suit. Le choix du langage modifie d'importantes catégories de risques, mais un produit doit être jugé sur les opérations qu'il effectue réellement. [17] [18] [19]
L'article de Szekeres, Payer, Wei et Song (2013) sur l'état de la connaissance (SoK) examine le développement des attaques par corruption de mémoire et les mécanismes de défense mis en œuvre. Leur analyse distingue la prévention des opérations mémoire invalides, la détection de la corruption et le renforcement de la difficulté d'exploitation après l'apparition d'une faille. Ces garanties sont fondamentalement différentes. Bien que cet article soit antérieur aux nouvelles mesures d'atténuation intégrées aux compilateurs et au matériel, sa classification explique pourquoi le blocage d'une technique d'exploitation ne garantit pas la suppression de la faille mémoire sous-jacente. [20]
Des langages plus sûrs sont utiles, mais les systèmes existants ne peuvent être remplacés du jour au lendemain. Le C et le C++ sont profondément intégrés aux systèmes d'exploitation, aux microprogrammes et aux bibliothèques spécialisées, dont beaucoup sont soumis à des contraintes de performance, de matériel ou de compatibilité. Leur réécriture peut introduire ses propres défauts, et les équipes ont besoin des compétences et des outils nécessaires pour valider les solutions de remplacement. Cela ne justifie pas pour autant d'accepter indéfiniment une gestion de la mémoire non sécurisée. L'évaluation pratique consiste à déterminer où des données non fiables accèdent à des opérations non contrôlées, quelles dépendances natives subsistent, quels privilèges possèdent ces composants et comment les tests, les mesures d'atténuation et la maintenance permettent de gérer le risque. Une simple étiquette de langage ne peut répondre à ces questions. [2]
Quand la conception est vulnérable
Les failles de conception peuvent être tout aussi graves que les défauts de gestion de la mémoire ou d'application du sandbox. Elles surviennent lorsque les règles ou les flux de travail prévus par un système permettent un résultat nuisible, même si le logiciel les respecte scrupuleusement. Un code sécurisé en mémoire, des composants rigoureusement contrôlés et un chiffrement robuste ne sauraient compenser une conception qui autorise une personne non autorisée à accéder à une opération protégée.
Imaginez un service fictif de sauvegarde chiffrée. Sa fonction de récupération exige une authentification, mais renvoie ensuite la clé de récupération pour tout identifiant de sauvegarde fourni, sans vérifier si la sauvegarde appartient à l'utilisateur. Un attaquant disposant d'un compte ordinaire et connaissant l'identifiant d'un autre client peut ainsi obtenir sa clé. Aucun chiffrement n'est compromis, aucune mémoire n'est corrompue et aucun environnement isolé n'est contourné. Le système transmet le secret car sa conception n'a jamais exigé le contrôle d'autorisation nécessaire.
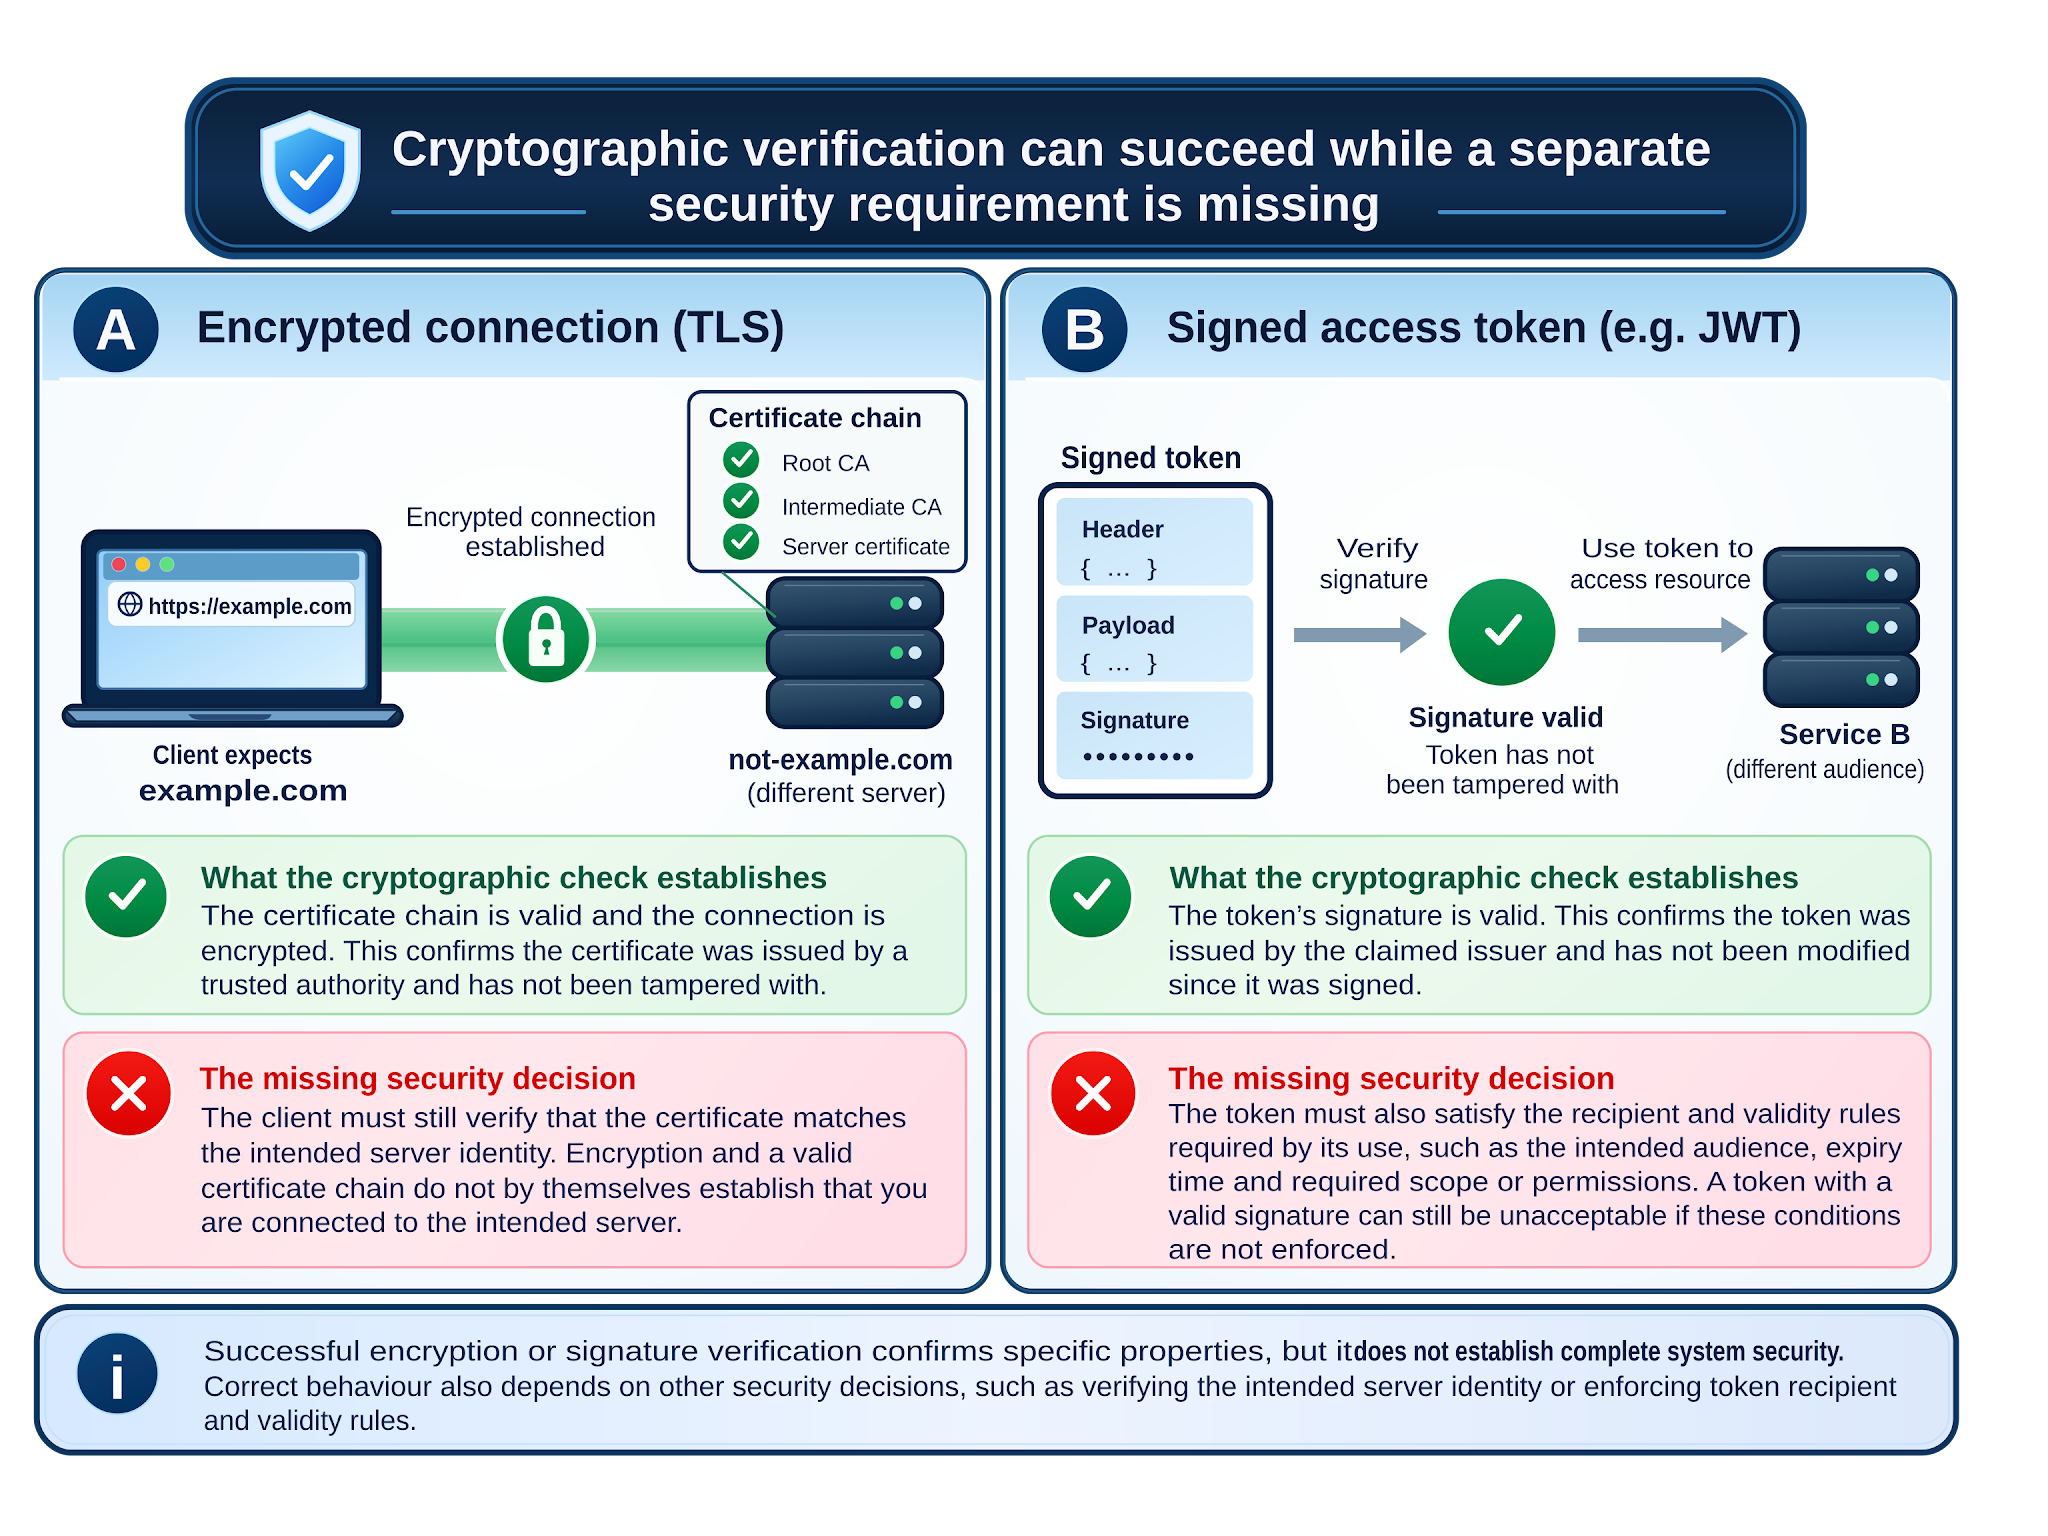
La cryptographie offre un autre exemple de protection adéquate appliquée à une décision de sécurité incomplète. Le chiffrement peut protéger les informations transitant entre ordinateurs sans qu'il soit nécessaire d'établir quel service se trouve à l'autre extrémité ni si une requête doit être acceptée. Ces éléments requièrent des vérifications distinctes. Un protocole définit les messages et les vérifications que les systèmes communicants sont censés utiliser ; l'implémentation est le logiciel qui respecte ces règles. Une implémentation peut omettre une vérification requise, tandis qu'un protocole peut lui-même omettre une exigence nécessaire. Le bon fonctionnement d'une protection ne garantit donc pas la sécurité de l'opération complète. [21]
Prenons l'exemple d'un programme se connectant à un site web. Il peut établir une connexion chiffrée et accepter un certificat d'un émetteur de confiance sans vérifier si ce certificat identifie correctement le site web cible. Le chiffrement fonctionne, mais le programme risque de communiquer avec un imposteur. Une erreur similaire se produit avec les jetons d'accès signés, des identifiants numériques utilisés par certains services pour décider d'accepter ou non les requêtes. Un programme peut vérifier la signature du jeton sans vérifier s'il provient d'un émetteur reconnu, s'il est destiné à ce service ou s'il est toujours valide. Dans les deux cas, une vérification correcte laisse une autre décision nécessaire en suspens. Aucune de ces défaillances n'implique un chiffrement défaillant ou une signature falsifiée. L'ouvrage de Ross Anderson, « Why Cryptosystems Fail », examine l'écart plus large entre les protections cryptographiques et les défaillances des systèmes réels. [22] [23] [24]
L’étude de Clark et van Oorschot de 2013 sur l’état de la connaissance (SoK) du protocole SSL et HTTPS a examiné l’influence de l’émission des certificats, des décisions de confiance des navigateurs et des pratiques d’infrastructure sur la sécurité des connexions chiffrées. Leur étude a intégré la confiance en l’identité et les certificats dans un système plus vaste, au lieu de considérer le chiffrement comme suffisant en soi. Elle a analysé les mécanismes de l’époque, et non les déploiements TLS actuels ni les protections introduites ultérieurement ; les implémentations actuelles doivent être évaluées au regard des normes en vigueur. [25]
Les secrets peuvent également fuiter par le biais de comportements non intentionnels. Différents messages d'erreur peuvent révéler l'existence d'un compte. Une vérification dont la durée varie selon un secret peut, si cette différence est observable de manière fiable, entraîner une fuite d'informations via un canal auxiliaire temporel. Ces fuites peuvent se produire sans demande directe du secret ni faille dans l'algorithme de chiffrement. Toute différence mesurable n'est pas exploitable ; le signal, les conditions et les déductions possibles sont tous déterminants. [26]
La sécurité diffère de la gestion classique des pannes car un attaquant peut délibérément créer des conditions qu'un concepteur jugeait improbables. Une entrée malformée, une séquence de requêtes inhabituelle ou une dépendance compromise peuvent être testées à plusieurs reprises jusqu'à ce qu'une solution produise l'effet désiré. Les tests de routine montrent le comportement des cas connus ; ils ne garantissent pas l'exclusion de toutes les combinaisons malveillantes. La question est de savoir quelles protections restent efficaces lorsqu'une hypothèse s'avère fausse.
Une vulnérabilité de conception peut également être inhérente à un protocole : une implémentation peut suivre fidèlement ses règles même si celles-ci permettent de rejouer, de rediriger ou de détourner un message par ailleurs valide. Ross Anderson et Roger Needham ont exploré cette perspective adverse dans *Programming Satan’s Computer* [27]. Même un logiciel correctement spécifié et implémenté dépend du matériel pour préserver les limites qu’il attend.
Lorsque le matériel lui-même est vulnérable
Le logiciel dépend du matériel pour faire respecter les restrictions de base. Un programme ne doit pas pouvoir modifier la mémoire protégée d'un autre programme, les informations restreintes par le processeur doivent rester inaccessibles et un appareil doit démarrer dans un état fiable. Or, les processeurs, les puces mémoire et le code bas niveau qui lance un appareil sont eux-mêmes des systèmes complexes. Leur comportement peut compromettre une règle de sécurité, même si l'application qui les surplombe est correctement conçue.
⚠️ Rowhammer révèle une faiblesse physique inattendue. Dans certaines puces mémoire, l'accès répété à des emplacements mémoire spécifiques peut perturber électriquement les cellules voisines jusqu'à ce que les bits stockés soient modifiés. Or, le logiciel n'a pas demandé ces modifications. Des chercheurs ont démontré que, sur les systèmes vulnérables et dans certaines conditions, cet effet peut être exploité pour contourner les protections de la mémoire et obtenir des privilèges plus élevés. Un programme peut respecter les règles d'écriture autorisées, mais la mémoire physique peut néanmoins modifier des informations en dehors de ces limites. Rowhammer n'affecte pas tous les types de mémoire de la même manière, et son exploitation pratique ainsi que les mesures d'atténuation dépendent du matériel et du système. [28] [29]
⚠️ D'autres failles matérielles peuvent révéler des informations sans les modifier. Les processeurs modernes effectuent parfois des calculs à l'avance, en prédisant les instructions nécessaires pour gagner du temps. C'est ce qu'on appelle l'exécution spéculative. Si la prédiction s'avère erronée, le résultat provisoire est ignoré, mais des traces de ce travail peuvent subsister dans le cache, une petite zone de stockage permettant au processeur de récupérer rapidement les informations récemment utilisées. L'analyse de ces traces peut parfois révéler des secrets que le programme n'était pas autorisé à lire. Les failles Spectre ont manipulé ces prédictions pour provoquer de telles divulgations ; Meltdown a exploité une autre faille dans la manière dont certains processeurs traitaient les données protégées avant qu'une violation d'accès ne se produise. Il s'agit de canaux auxiliaires du processeur, liés aux fuites temporelles décrites précédemment. Ils concernent la manière dont un processeur exécute les instructions en interne, et non simplement le jeu d'instructions publié décrivant les opérations que le logiciel peut demander. Les processeurs concernés, les conditions et les contre-mesures varient. [30] [31] [32]
La sécurité peut également être compromise avant même le démarrage du système d'exploitation. Le démarrage sécurisé établit une chaîne de confiance en vérifiant que chaque étape du démarrage est autorisée avant son exécution. Certains appareils stockent le code de démarrage initial dans une mémoire morte (ROM), qui n'est généralement pas réinscriptible après sa fabrication. Cela complique les falsifications ultérieures, mais signifie également qu'un défaut dans la routine de vérification ou de récupération d'origine peut être impossible à corriger dans la ROM.
⚠️ La divulgation en 2018 de la vulnérabilité Fusée Gelée du mode de récupération du Tegra X1 illustre une faille accessible physiquement via USB, et non via un service réseau distant. Les modifications logicielles et les restrictions opérationnelles peuvent réduire l'exposition, mais elles ne peuvent pas réécrire une ROM de démarrage véritablement immuable. Le démarrage sécurisé conserve toute sa valeur grâce aux garanties offertes par sa racine de confiance et aux conditions d'attaque qu'il couvre. [33] [34] [35]
⚠️ L'étude SoK de Glosner et Machiry (2026) a examiné 43 chargeurs d'amorçage dans la chaîne d'amorçage logiciel après le transfert de la racine matérielle. Leur ensemble de données BOOTBENCH recense 3 658 vulnérabilités signalées et les modifications associées. Les auteurs ont identifié des limites dans les techniques de détection et de renforcement existantes. Ces chiffres ne permettent pas d'affirmer que chaque chargeur d'amorçage est exploitable ni qu'un dispositif particulier est vulnérable. Ils montrent simplement pourquoi vérifier qu'un logiciel d'amorçage provient d'une source autorisée est différent d'établir que l'implémentation autorisée ne présente aucun défaut exploitable. [36]
Le matériel illustre les limites d'une assurance monocouche. La sécurité des applications dépend notamment de la gestion de la mémoire par le processeur, de sa chaîne de démarrage et de la mise en œuvre des protections matérielles annoncées. Ces dépendances ne rendent pas les défenses matérielles inutiles ; elles définissent les conditions dans lesquelles un logiciel peut s'y fier.
Contenir une défaillance avant qu'elle ne se propage
L'ingénierie de la sécurité permet également de limiter les conséquences d'une faille non corrigée. Un programme manipulant un format de fichier inhabituel ne doit pas bénéficier automatiquement du même accès aux données privées, aux services réseau et aux opérations puissantes que l'application qui l'a appelé. Les systèmes d'exploitation peuvent imposer des limites entre les processus en cours d'exécution et restreindre leurs permissions. Un environnement isolé (sandbox) est un ensemble de telles limites. La question pertinente est de savoir quel composant en cours d'exécution est privé d'accès à quelles ressources. Placer des fichiers dans des dossiers sources distincts, appeler une fonction via un langage de programmation différent ou décrire une bibliothèque comme isolée ne suffit pas, en soi, à établir une limite au sein du système d'exploitation. [10]
Un décodeur natif chargé dans l'application principale partage généralement le processus, la mémoire et une grande partie des droits de cette application. Déplacer le décodage vers un processus distinct confère à ce dernier un espace d'adressage spécifique. Appliquer des restrictions supplémentaires, judicieusement ciblées, à ce processus permet de limiter l'impact direct d'une faille ou d'une compromission. Les deux versions peuvent coexister dans le même environnement isolé de l'application ; la protection supplémentaire provient des limites et des permissions propres au processus. Cette configuration engendre des coûts en termes de communication, de délais d'attente et de récupération, et l'hôte doit toujours inspecter les résultats du processus. Un processus restreint, autorisé à demander des opérations sur des fichiers privilégiées arbitraires à son hôte, risque de reproduire le problème de l'« adjoint confus » au-delà des limites du processus.
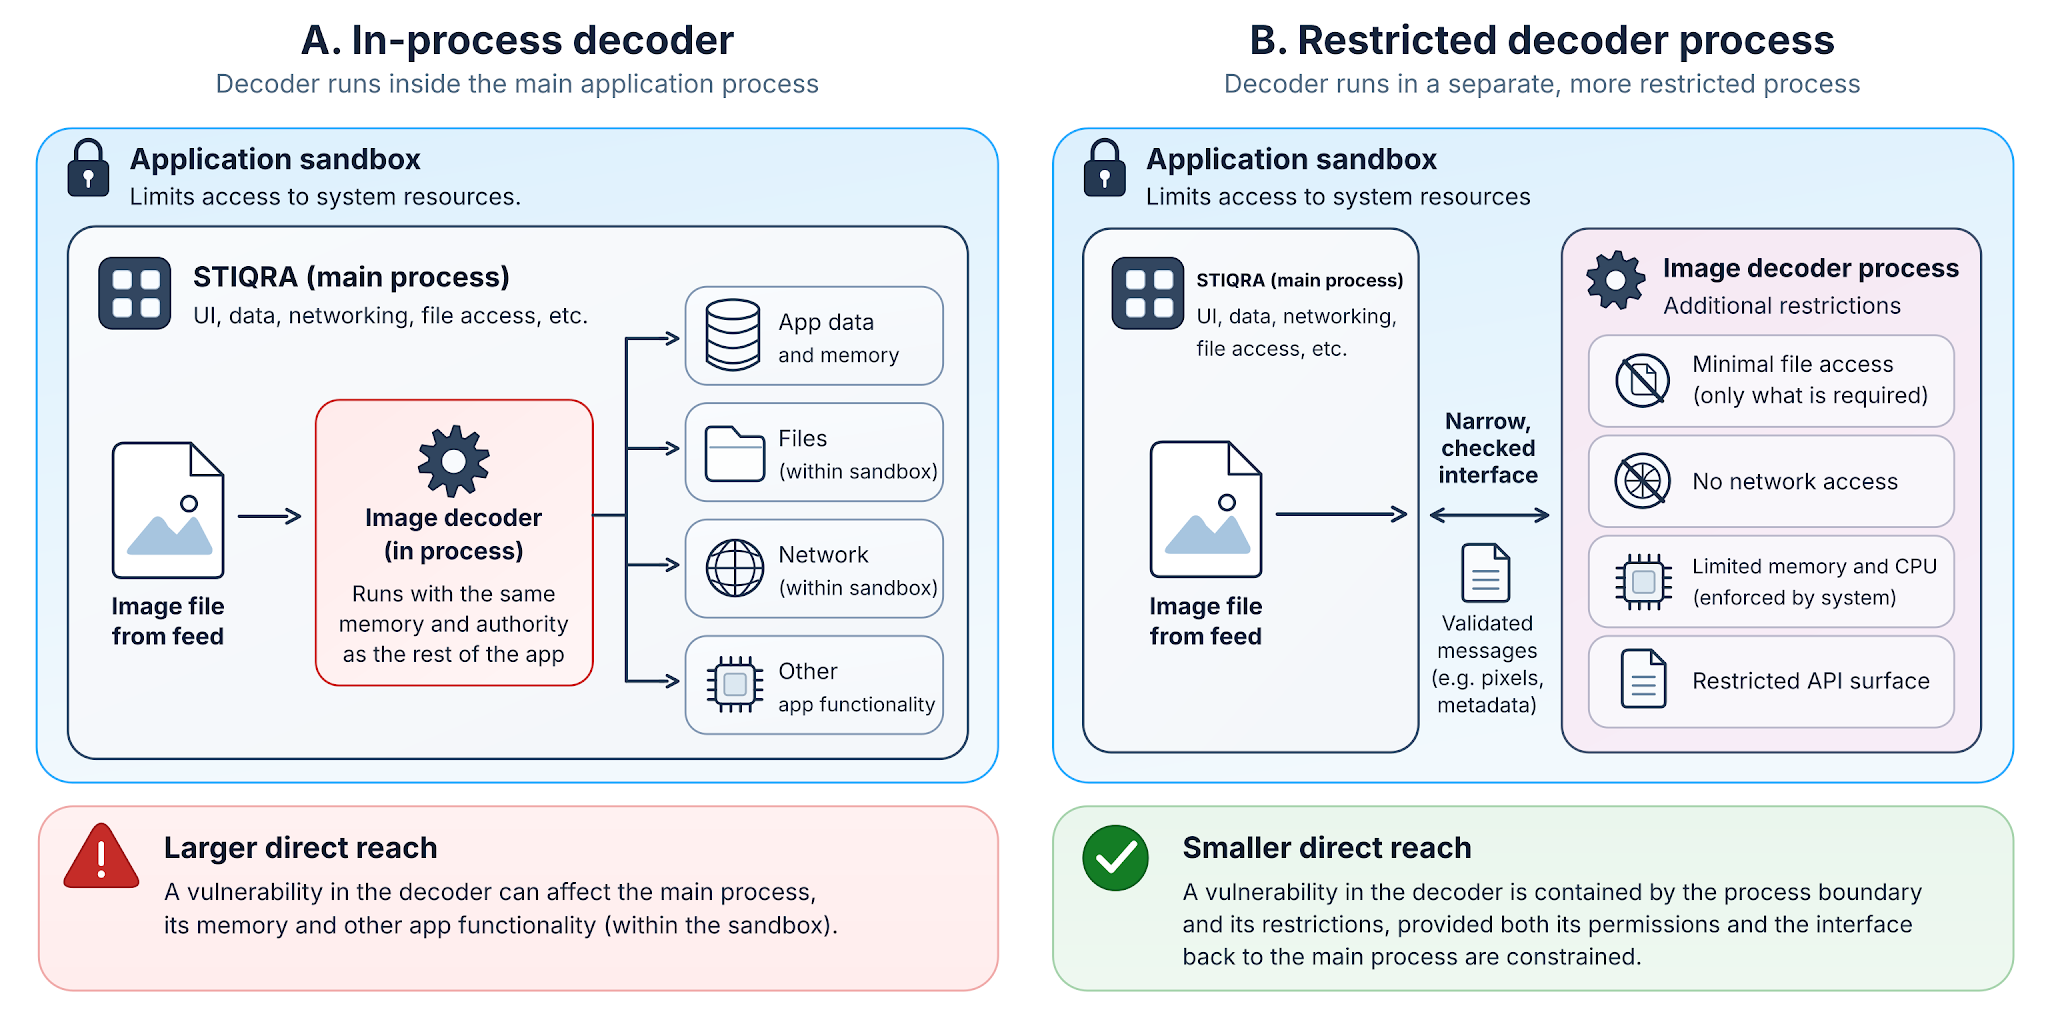
De nombreuses recherches portent sur la réussite ou l'échec de ces frontières en pratique. L'étude SoK 2025 de Lefeuvre et ses collègues a analysé 211 projets de recherche et 61 systèmes compartimentés courants. Elle a mis en évidence des difficultés persistantes pour définir des politiques d'isolation utilisables, transposer la recherche en production et évaluer les menaces liées à la confusion des mandataires et aux contraintes matérielles. Un processus distinct ne constitue pas une preuve de confinement efficace si ses permissions sont excessives ou si un hôte privilégié agit sur des requêtes non restreintes émanant de lui. La tâche d'ingénierie pertinente consiste à définir l'autorité disponible de part et d'autre d'une interface et à démontrer que les frontières appliquées correspondent à cette conception. [37]
Le confinement illustre un principe général : la prévention et la limitation des dommages ont des rôles distincts. Les contrôles d’entrée visent à bloquer une opération nuisible avant même son exécution. Les règles de sécurité de la mémoire empêchent certains accès invalides. Le sandboxing limite les ressources accessibles à un code défectueux. La surveillance et la récupération permettent à un service de reconnaître et de gérer les défaillances potentielles. Plusieurs protections peuvent atténuer les conséquences d’une erreur, mais leur indépendance doit être démontrée et non présumée. Une faille exploitée avec succès peut donc rester confinée à un composant restreint ; elle n’octroie pas automatiquement l’accès à l’ensemble du système. Une déclaration de sécurité honnête identifie l’effet prohibé et les mécanismes qui appliquent les limites pertinentes, plutôt que de recenser les technologies ou de mettre en avant le terme « sécurisé ». [38]
⚠️ Les limites du confinement et de la protection du matériel
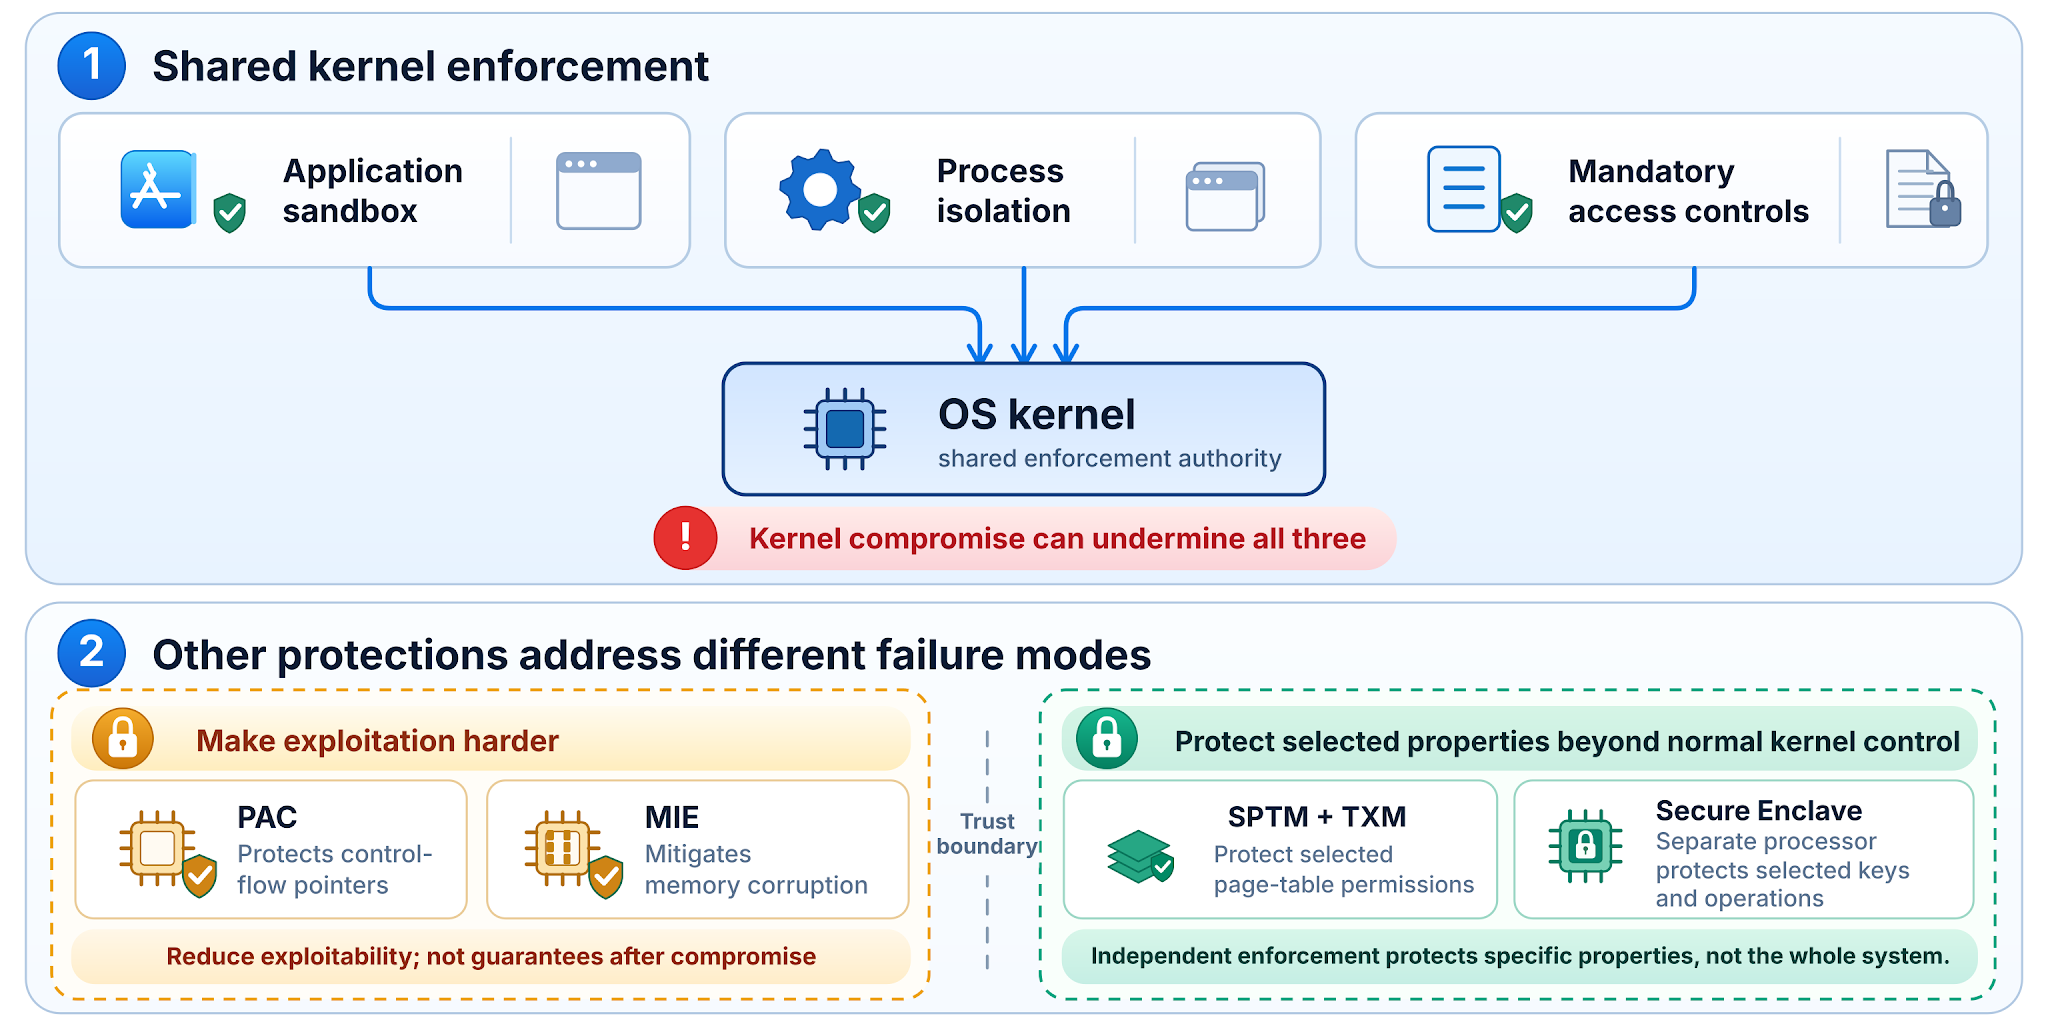
Certaines protections semblent indépendantes car elles portent des noms et des paramètres différents, alors qu'elles dépendent de la même autorité. Les environnements d'exécution isolés (sandboxes) pour les applications, l'isolation des processus et les contrôles d'accès obligatoires s'appuient généralement sur le noyau du système d'exploitation pour appliquer leurs restrictions. Le noyau est le composant central qui gère les programmes, la mémoire et les permissions. Si un attaquant obtient un contrôle suffisant sur le noyau, il peut modifier ou ignorer les règles dont dépendent ces protections. Plusieurs couches de protection ne constituent pas nécessairement plusieurs lignes de défense indépendantes. [39]
Les mesures d'atténuation matérielles peuvent rendre la compromission du noyau plus difficile. L'authentification des pointeurs (PAC) signe et authentifie certains pointeurs, contrant ainsi certaines attaques par injection de flux de contrôle qui reposent sur leur corruption. Sur les systèmes Apple prenant en charge l'application de l'intégrité de la mémoire (MIE), le marquage matériel de la mémoire, l'allocation typée et les restrictions associées du système d'exploitation empêchent certaines formes d'exploitation de la corruption de mémoire, notamment les attaques contre le code système protégé. Aucun de ces mécanismes ne constitue une autorité indépendante capable de garantir le respect de la politique de sandbox des applications une fois qu'un attaquant a obtenu un contrôle suffisant du noyau. [40]
Certaines protections opèrent en dehors du contrôle habituel du noyau. Sur les systèmes Apple compatibles, le moniteur de table de pages sécurisée (SPTM), en collaboration avec un moniteur d'exécution de confiance, limite certaines modifications de la table des pages, même lorsqu'un attaquant a obtenu des droits d'écriture sur le noyau. Il s'agit de restrictions d'intégrité de la mémoire et du code, limitées et prises en charge par le matériel, et non d'une confiance continue dans les décisions du noyau concernant les utilisateurs, les fichiers ou l'accès au réseau. Les propriétés qui persistent dépendent de la plateforme et des capacités de l'attaquant. [39]
Secure Enclave est un exemple de barrière de sécurité distincte. Sur les appareils Apple compatibles, il s’agit d’un processeur de sécurité doté de son propre démarrage sécurisé, d’une mémoire protégée et d’un micro-noyau. Ce processeur est conçu pour protéger certains secrets, même si le noyau du système d’exploitation principal est compromis. Une application peut générer une clé privée pour les opérations gérées par Secure Enclave et demander des opérations cryptographiques autorisées sans recevoir la clé elle-même. Ce qui reste protégé dépend de la politique d’accès de la clé et des opérations que l’Enclave est chargée d’appliquer, et non de la simple présence de la puce. [41] [42]
D'autres systèmes utilisent des limites matérielles différentes. Un module de plateforme sécurisée (TPM), implémenté comme un dispositif distinct ou au sein d'un processeur, protège certaines clés cryptographiques et peut lier leur utilisation à des mesures du démarrage du système ; il ne s'agit pas d'un environnement d'exécution général pour le code applicatif. Sur les processeurs compatibles, Arm TrustZone sépare les états d'exécution sécurisés et normaux, permettant ainsi aux logiciels et ressources désignés de rester inaccessibles au système d'exploitation normal lorsque le système est correctement conçu. Sur les processeurs compatibles, Intel Software Guard Extensions (SGX) isole le code applicatif et les données sélectionnés dans des enclaves, les protégeant ainsi des logiciels privilégiés, y compris le noyau du système d'exploitation. Contrairement à la Secure Enclave d'Apple, TrustZone et SGX ne nécessitent pas de processeur de sécurité dédié. Ils protègent également des ressources différentes et ne sont pas interchangeables. [43] [44] [45]
Le maintien d'une autorité de sécurité indépendante du noyau principal peut également contribuer à rétablir la confiance dans la plateforme après une compromission de ce dernier. Un chemin de démarrage ou de récupération fiable, ancré hors du contrôle du noyau, peut vérifier l'autorisation du micrologiciel et du système d'exploitation avant la remise en service du périphérique. Des clés protégées et des mesures du processus de démarrage peuvent faciliter ces vérifications. Le NIST distingue différentes racines de confiance pour la détection des modifications non autorisées, l'approbation des mises à jour et la récupération du micrologiciel endommagé de la plateforme. Ces éléments doivent être intégrés dans un processus de récupération fonctionnel : un TPM, une enclave sécurisée, un environnement TrustZone ou une enclave SGX ne suffit pas, à eux seuls, à restaurer un système d'exploitation compromis. [35] [38]
Une telle récupération n'est possible que dans le cadre d'un modèle de menace défini. Le micrologiciel de récupération, la racine de confiance matérielle et le logiciel de remplacement source doivent eux-mêmes rester fiables. Tant que le noyau compromis n'est pas remplacé, un attaquant peut manipuler les requêtes adressées aux composants sécurisés, interrompre le service ou inspecter des informations avant ou après la levée de la protection, même si certaines clés ou la mémoire de l'enclave restent inaccessibles. La récupération ne permet pas d'annuler les informations déjà divulguées. La différence réside entre la protection d'un état sélectionné pendant une compromission et le rétablissement d'un fonctionnement fiable par la suite.
L'étude de Zinkus, Jois et Green (2022) a examiné la confidentialité des données sur les appareils mobiles face à de puissants adversaires capables d'en extraire des informations, notamment ceux ayant un accès physique à l'appareil ou un accès aux services cloud associés. Son champ d'application dépasse la simple protection d'une clé : les informations peuvent également être exposées avant leur sécurisation, après leur déchiffrement ou via des services dépendants. Cette analyse historique ne valide pas le comportement actuel du SPTM ou de la Secure Enclave. Elle souligne la nécessité de préciser quelles informations restent protégées, contre quelles capacités et à quel moment elles franchissent le périmètre de confiance. [46]
Les limites des protections dépendantes du noyau
| Mécanisme | Ce qu'il protège réellement | Après la compromission du noyau principal |
|---|---|---|
| Sandbox, isolation des processus et MAC | Le noyau impose ces limites ; un attaquant qui le contrôle peut les contourner. | ✕ Non fiable |
| Authentification par pointeur (PAC) | Rend plus difficiles certaines exploitations de corruption de pointeurs ; n’impose pas les règles du noyau après sa prise de contrôle. | ✕ Non indépendant |
| Application de l'intégrité de la mémoire (MIE) | Contrôle les accès à la mémoire protégée ; ne peut pas rendre un noyau compromis digne de confiance. | ✕ Aucune garantie générale |
| Moniteur de table de pages sécurisé (SPTM) | Avec TXM, il applique certaines restrictions de table de pages en dehors du contrôle ordinaire du noyau. | ⚠ Restrictions sélectionnées |
| Secure Enclave | Un processeur distinct et son micro-noyau protègent certaines clés et opérations. | ✓ À l'intérieur de ses limites |
SPTM peut préserver certaines restrictions de mémoire après une compromission du noyau, et l'Enclave sécurisée peut protéger des clés désignées. Aucun des deux ne rétablit à lui seul la confiance dans le système d'exploitation.
Un iPhone peut prendre en charge MIE et PAC, mais cela ne signifie pas que toutes les applications exécutées dessus utilisent les deux protections. Apple déploie automatiquement MIE sur certaines surfaces d'attaque du système, y compris le noyau. Cette protection ne s'étend pas automatiquement à toutes les applications, extensions, processus auxiliaires ou bibliothèques tierces. Deux applications exécutées sur le même iPhone compatible peuvent donc avoir des protections différentes. MIE combine du matériel conçu par Apple, des allocateurs de mémoire sécurisés et des contrôles du système d'exploitation ; il ne s'agit pas simplement de l'extension de marquage de mémoire Arm (MTE) standard.
Pour utiliser le marquage matériel de la mémoire dans leurs applications, les développeurs doivent l'activer pour les cibles Xcode concernées et vérifier la compatibilité matérielle. Les droits d'accès et les paramètres d'exécution sont également importants : un mode de diagnostic signalant des erreurs simulées ne garantit pas l'application effective des vérifications. PAC est une mesure d'atténuation distincte. La compatibilité matérielle ne signifie pas pour autant que chaque binaire d'application utilise PAC ; le code concerné doit être compilé pour l'architecture arm64e appropriée et les bibliothèques natives externes doivent être compilées de manière compatible. Les développeurs doivent vérifier les protections activées dans la version finale, y compris ses composants et dépendances, et effectuer des tests sur des appareils physiques compatibles. Une spécification de périphérique ne constitue pas une preuve du fonctionnement des protections dans une application donnée. [47] [48] [49]
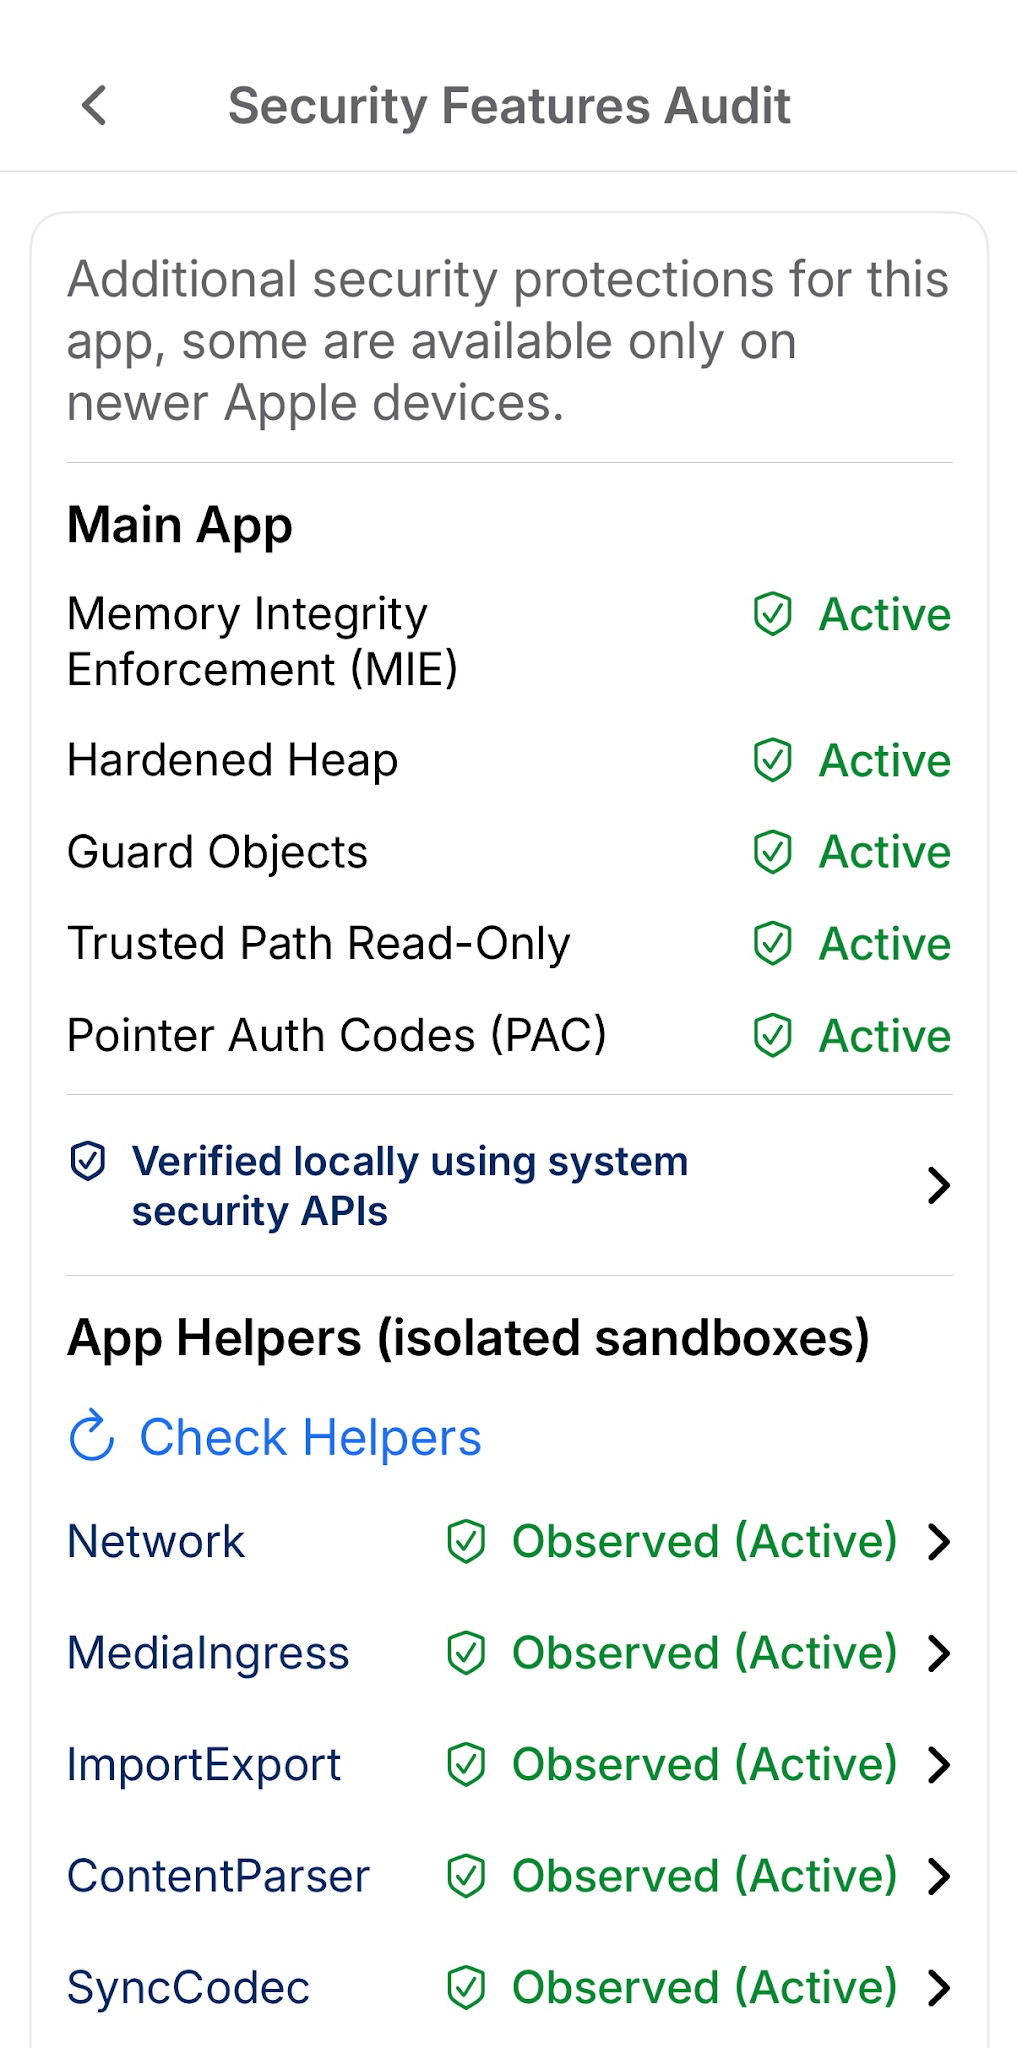
Un schéma d'architecture ou une liste de fonctionnalités ne permettent pas de déterminer quelles mesures de protection sont efficaces dans le produit final. Les éléments pertinents sont les processus effectivement protégés, l'autorité chargée de faire respecter chaque restriction et ce qui reste protégé dans les conditions de défaillance envisagées.
Lorsque les mécanismes de sécurité échouent
Les restrictions de sécurité doivent rester en vigueur même en cas d'échec d'un contrôle ou d'une opération requise. Si un service d'autorisation est indisponible, l'absence de décision ne vaut pas autorisation de poursuivre. Si une modification en plusieurs étapes est interrompue, les enregistrements partiellement mis à jour peuvent enfreindre les règles que l'opération visait à préserver. La réponse doit être définie pour chaque tâche : rejeter ou reporter une action non vérifiée, préserver la cohérence de l'état et permettre la reprise du travail interrompu. Considérer une erreur comme une approbation constitue un défaut de type « fail-open » ; considérer toute erreur comme une panne permanente n'est pas non plus une conception adéquate. [50]
Une compromission ne s'arrête pas nécessairement au premier compte ou processus atteint. Un attaquant peut exploiter ce point d'entrée pour obtenir des privilèges plus élevés (élévation de privilèges) ou pour accéder à d'autres systèmes (mouvement latéral). Chaque étape suivante dépend d'une autre vulnérabilité exploitable, d'identifiants ou d'une relation de confiance ; le contrôle d'un service n'implique pas automatiquement le contrôle des services voisins. C'est pourquoi l'autorité disponible au point d'entrée initial, la séparation entre les systèmes et les contrôles des requêtes privilégiées déterminent l'étendue de la propagation d'une attaque. Le confinement peut interrompre la progression même après la compromission du premier composant. [51] [52]
La reprise opérationnelle est essentielle lorsque la prévention et le confinement ne suffisent pas. Un attaquant qui obtient le contrôle administratif peut modifier des enregistrements, effacer des fichiers ou déployer un rançongiciel rendant les données inutilisables. Une sauvegarde peut atténuer les dommages causés par la destruction ou la corruption des données, mais elle ne permet pas de récupérer les informations déjà volées. Une sauvegarde conservée avec les mêmes permissions compromises peut également être altérée ou effacée par l'attaquant. Il est donc important, au même titre que les correctifs de sécurité, de disposer de copies récupérables et correctement protégées, ainsi que d'exercices permettant de vérifier la restauration. La surveillance permet de détecter les activités inhabituelles et de préserver les preuves ; les procédures d'incident définissent les personnes habilitées à isoler les systèmes affectés, à révoquer les identifiants et à rétablir un service fiable. Ces mesures ne constituent pas un aveu d'échec de la conception sécurisée. Elles reconnaissent que la protection d'un système implique de limiter les dommages causés par les défaillances restantes et de rétablir le fonctionnement normal des systèmes. [38]
Lorsque la chaîne d'approvisionnement compromet la sécurité
Même une petite application dépend de logiciels écrits, compilés et maintenus par des tiers : composants du système d’exploitation, bibliothèques, outils de développement et services externes. Une faille signalée n’a d’importance que si une version affectée est présente et qu’une opération pertinente est exposée, mais l’établir peut s’avérer complexe compte tenu des dépendances maintenues selon des calendriers différents. Le nom d’un produit renseigne donc peu sur les composants et services réellement impliqués dans son fonctionnement. [53]
Une comparaison utile est celle d'une liste d'ingrédients. Un fabricant incapable d'identifier les ingrédients d'un produit ne peut déterminer facilement si un problème nouvellement découvert s'applique à ce produit. Les logiciels présentent la même difficulté. Une nomenclature logicielle (SBOM) recense les composants et leurs versions afin d'améliorer la visibilité, y compris les dépendances issues d'autres dépendances. Elle aide une organisation à déterminer si une bibliothèque vulnérable signalée est présente, mais ne constitue pas une garantie de sécurité. L'inventaire peut être incomplet, le code vulnérable peut rester inaccessible, ou un composant absent d'une version peut apparaître dans la suivante. L'inventaire devient utile lorsqu'il est tenu à jour, relié à l'infrastructure réellement déployée et qu'un processus d'évaluation et de réparation des systèmes affectés est mis en place. [54]
L’ouvrage SoK 2026 d’Abu Ishgair et ses collègues utilise le modèle AStRA pour examiner les acteurs, les étapes, les ressources et les artefacts impliqués dans la production et la distribution de logiciels. Il distingue les questions auxquelles une nomenclature des logiciels (SBOM) peut répondre de celles qui nécessitent des preuves concernant les modifications du code source, l’intégrité des compilations, l’autorité de publication et la livraison. Un inventaire complet ne garantit pas la fiabilité d’une compilation, et la provenance ne garantit pas l’absence de défauts dans le programme résultant. Les preuves doivent correspondre au risque spécifique de la chaîne d’approvisionnement évalué. [55]
La connaissance des composants présents ne garantit pas la fiabilité de leur contenu ni de leur distribution. Un attaquant peut introduire un comportement malveillant dans une dépendance, un dépôt de code source, un processus de compilation ou une mise à jour logicielle, de sorte que les utilisateurs reçoivent du code malveillant dans le cadre d'une version apparemment légitime. Il s'agit d'une compromission de la chaîne d'approvisionnement logicielle, distincte de la découverte accidentelle d'une vulnérabilité dans un composant. Vérifier l'origine et l'intégrité d'un paquet peut aider à détecter une substitution non autorisée, mais même une version correctement signée peut être malveillante si le fournisseur ou son processus de compilation a été compromis. La protection de la distribution logicielle exige donc également des contrôles sur les personnes autorisées à modifier le code et les versions, sur la gestion des identifiants de compilation et sur les preuves reliant un artefact distribué à sa source prévue. Une nomenclature des composants logiciels (SBOM) identifie les ingrédients ; elle ne certifie pas que leur contenu ou leur chemin de distribution sont sûrs. [53]
Le logiciel ne transite pas directement de l'éditeur du programmeur à l'appareil de l'utilisateur. Le code passe par des responsables de maintenance, des dépôts, des outils de compilation, des services automatisés, des clés de signature, des approbateurs de versions et des canaux de distribution. Un relecteur peut examiner le code source et pourtant ne pas détecter une modification malveillante introduite lors de la création du package ; un outil de compilation rigoureusement contrôlé offre peu de protection si un intrus peut autoriser ce qu'il génère. Il est important de séparer et de vérifier ces responsabilités, car une version d'apparence légitime peut avoir été altérée à une étape invisible pour l'utilisateur final. [56]
La porte dérobée xz Utils de 2024 a mis en lumière ce problème avec une clarté inhabituelle. Du code malveillant était dissimulé dans les archives de distribution et conçu pour affecter certaines compilations de paquets Linux, compromettant potentiellement l'authentification à distance sur les systèmes présentant des dépendances particulières. L'archive de distribution n'était pas simplement équivalente au code source qu'un examinateur aurait pu consulter dans le dépôt public : le processus de compilation déterminait le contenu du logiciel. L'attaque a été détectée avant que les versions affectées ne se généralisent dans les distributions Linux stables, mais elle a démontré qu'une version amont apparemment autorisée pouvait intégrer des fonctionnalités malveillantes délibérément introduites dans les paquets en aval. C'est pourquoi faire confiance à un projet connu ou à son chemin de téléchargement officiel ne suffit pas. Il s'agissait d'une compromission de la chaîne d'approvisionnement, et non d'un défaut de programmation accidentel. [57] [58]
La traçabilité des compilations vise à relier un exécutable livré à sa source, aux outils, aux paramètres et au service qui l'ont produit. Les compilations reproductibles peuvent fournir des preuves supplémentaires lorsque des parties indépendantes obtiennent des résultats concordants à partir de la même source. Des cadres tels que SLSA décrivent des méthodes pour enregistrer et vérifier cet historique. Cependant, la fiabilité d'un enregistrement dépend de celle des systèmes qui le produisent et des critères indépendants par rapport auxquels il est vérifié. Une source compromise peut être compilée de manière reproductible ; un service de compilation corrompu peut fournir de fausses assurances ; une déclaration signée mais non vérifiée n'a que peu de valeur. La traçabilité permet d'établir des éléments de la chaîne de traçabilité, mais ne garantit pas la sécurité du logiciel sous-jacent. [59] [60]
La signature et la distribution d'une version constituent deux processus distincts. Une signature numérique valide atteste qu'un artefact a été signé à l'aide d'une clé spécifique et qu'il n'a pas été modifié ultérieurement. Elle ne permet cependant pas de garantir la fiabilité du signataire, l'intégrité de la clé ni la sécurité du programme signé. Une version signée constitue une preuve d'autorisation par une clé, et non un certificat d'innocuité. Le protocole HTTPS protège la connexion à un site de téléchargement ; il ne garantit pas l'intégrité du site, du compte de l'éditeur ou du téléchargement lui-même. Une somme de contrôle affichée sur une page compromise n'offre que peu de garanties indépendantes. Les systèmes de mise à jour sécurisés vérifient donc également l'éditeur attendu, les métadonnées de confiance, les versions et les autorités de signature autorisées, et protègent contre le retour à d'anciennes versions vulnérables. Ces contrôles réduisent le risque d'attaques spécifiques sans pour autant dispenser de la nécessité de faire confiance au processus de publication et de le protéger. [61]
La chaîne d'approvisionnement matérielle introduit un problème connexe plus difficile à contrôler. Une puce peut être conçue initialement avec soin, intégrer des circuits ou des composants provenant d'autres fournisseurs, puis passer par les étapes de fabrication, de test, de conditionnement, de transport et d'intégration. La conception théorique peut être valide, mais cela ne garantit pas que le silicium livré au client y soit conforme. Un adversaire ayant accès aux étapes concernées pourrait en principe modifier les circuits, insérer un cheval de Troie matériel caché, substituer des composants ou altérer le micrologiciel associé pendant la fabrication ou la livraison. Il s'agit de menaces reconnues à évaluer, et non de preuves qu'un fabricant ou un dispositif particulier a été compromis. [62] [63]
Un schéma validé ne garantit pas la validation de la puce. La vérification du fonctionnement normal, le test d'échantillons, l'examen des dossiers de production, le recours à des fournisseurs de confiance, la tenue de registres de traçabilité et l'authentification des composants contribuent à renforcer la sécurité matérielle. Toutefois, un comportement de circuit rare ou délibérément dissimulé peut échapper aux tests de routine, et l'identité ou le mécanisme d'attestation d'un dispositif repose sur des composants matériels et des clés dont l'origine doit également être fiable. Le démarrage sécurisé ne peut valider les logiciels ultérieurs que dans la mesure où le point de départ de cette validation est lui-même fiable. Aucun certificat ni aucune inspection ne peut garantir l'absence de modification malveillante tout au long de la chaîne. [62] [63]
Maintenance et course aux correctifs
Les mises à jour méritent une attention particulière car elles corrigent souvent des défauts déjà suffisamment bien identifiés pour être résolus. Dès qu'une faille est rendue publique, les attaquants peuvent rechercher les systèmes utilisant encore la version affectée. Certaines vulnérabilités sont déjà exploitées avant même la disponibilité d'un correctif. Retarder les mises à jour peut donc exposer un système à des méthodes qui ne nécessitent plus de recherches initiales de la part de l'attaquant. Le travail nécessaire ne se limite pas à cliquer sur un bouton de mise à jour : une organisation doit savoir quels ordinateurs et services elle possède, quelles versions ils utilisent, si un correctif existe auprès du fournisseur, si une fonction affectée est exposée et si la modification a été déployée avec succès. Les appareils et services dont le support fournisseur est arrivé à son terme posent un problème différent, car les correctifs de sécurité ne sont plus fournis. [64]
La responsabilité des mises à jour s'étend au-delà de l'application visible et englobe les systèmes d'exploitation, les navigateurs, les routeurs, les modules d'extension, les logiciels serveurs et les microprogrammes. Si les appareils grand public peuvent se mettre à jour automatiquement, les organisations exploitent également des machines peu utilisées, des services hérités et des systèmes tiers dont les versions ne sont pas clairement identifiées. Ces derniers sont faciles à négliger précisément parce qu'ils semblent fonctionner. Un inventaire précis, un responsable clairement identifié et la preuve qu'une mise à jour a bien été déployée sur le système en cours d'exécution permettent de distinguer un processus de correctif d'une simple liste de correctifs publiés.
Signaler une vulnérabilité ne signifie pas la corriger. Une étape essentielle de la réponse consiste à effectuer un triage de sécurité : déterminer si le logiciel concerné est présent, si la partie vulnérable est accessible, quelles actions un attaquant pourrait entreprendre et si quelqu’un l’exploite déjà. Cela permet d’établir l’urgence du problème, les personnes qui doivent intervenir et les éléments à vérifier. Un score de gravité peut être utile, mais il ne suffit pas à lui seul pour déterminer le danger pour un produit donné. Une décision de triage doit être réexaminée lorsque de nouveaux éléments ou des modifications logicielles apparaissent. Si une exploitation est en cours, des mesures de protection peuvent devoir être mises en œuvre avant la fin de l’évaluation. [65]
Il arrive qu'aucun correctif ne soit encore disponible. Même lorsqu'un correctif est rapidement publié, il doit être vérifié sur le produit, testé pour éviter toute altération des fonctions essentielles, puis déployé et validé dans la version utilisée par les utilisateurs. Pendant cette période, une faille connue peut encore être exploitée. Il peut alors être nécessaire de restreindre l'accès, de désactiver une fonctionnalité affectée, d'isoler un service ou, si besoin, de le mettre hors ligne. Ces mesures temporaires doivent être surveillées et évaluées jusqu'à la correction du défaut. L'installation d'un correctif ne permet pas non plus d'annuler une attaque qui aurait déjà eu lieu. [65]
Les attaquants peuvent agir plus rapidement que les correctifs ne parviennent aux utilisateurs qui en ont besoin. Dans des études portant sur des vulnérabilités effectivement exploitées, Mandiant a rapporté des délais d'exploitation moyens de 63 jours pour 2018-2019, 32 jours pour 2021-2022 et 5 jours pour 2023. Son rapport de 2026 estimait ce délai à -7 jours pour 2025, ce qui signifie que la première exploitation observée a précédé la disponibilité du correctif en moyenne dans les cas étudiés. Ces mesures concernent des vulnérabilités exploitées sélectionnées, et non des délais pour chaque faille ou des mesures de la vitesse d'installation des mises à jour par les utilisateurs. Les attaques zero-day affectent ces moyennes. Cette accélération a également commencé avant l'avènement des systèmes d'IA génératifs actuels. [66] [67] [68]
L'analyse assistée par l'IA accentue la difficulté de cette course déjà ardue. Un correctif publié ou une modification du code source peut révéler ce qui distingue une version vulnérable de son remplacement. Les outils automatisés permettent de comparer les versions, de développer des tests candidats et d'identifier les systèmes exposés, réduisant ainsi le travail nécessaire pour exploiter une faille connue. Des recherches menées en 2024 ont démontré qu'un agent basé sur un grand modèle de langage (LLM) pouvait exploiter plusieurs vulnérabilités précédemment divulguées dans des conditions contrôlées, à partir de leurs descriptions. En septembre 2026, Google Threat Intelligence a signalé une augmentation de l'exploitation observée de vulnérabilités à haut risque précédemment divulguées et a identifié l'analyse assistée par l'IA comme un facteur possible, sans toutefois prouver que l'IA était à l'origine de tous les incidents. [69] [70]
Cette capacité ne se limite pas aux services de modélisation dont les opérateurs peuvent surveiller ou restreindre les requêtes. Certains modèles de langage puissants sont diffusés avec des poids téléchargeables et peuvent être exécutés ou modifiés hors du contrôle de leurs créateurs ; leurs mécanismes de protection peuvent être absents, altérés ou supprimés. Des évaluations publiques réalisées en 2026 ont révélé des modèles à poids ouverts de plus en plus performants pour les tâches de cybersécurité. Cela ne signifie pas pour autant que chaque modèle est un attaquant efficace, ni que chaque vulnérabilité connue est facile à exploiter. L’IA aide également les équipes de défense à examiner le code, à découvrir les défauts et à préparer des réponses. Ce qui change, c’est le coût et la vitesse potentielle de la recherche de failles, y compris par des acteurs qui n’ont pas besoin de respecter les restrictions du fournisseur du modèle. [71] [72]
La publication d'un correctif ne garantit pas sa réception par les utilisateurs. Les responsables de la maintenance, les distributeurs et les opérateurs peuvent encore avoir besoin d'intégrer, de tester, d'approuver et de déployer la modification. Des attaquants peuvent exploiter les installations non encore déployées, tandis qu'un déploiement précipité peut engendrer de nouvelles défaillances. Le triage rapide, la protection temporaire et le déploiement vérifié sont donc des responsabilités complémentaires, et non des alternatives concurrentes.
La conception sécurisée est essentielle précisément parce que cette période d’exposition ne peut pas toujours être supprimée. Un code sécurisé en mémoire peut prévenir certains types d'erreurs de mémoire ; des permissions strictes et un environnement isolé peuvent limiter l'accès d'un composant compromis ; des limites d'entrée et de ressources peuvent compliquer d'autres attaques. Ces protections sont utiles avant même la découverte d'une vulnérabilité, ainsi que pendant la préparation et les tests d'un correctif. La capacité à résister à certaines défaillances, à limiter les dommages et à se rétablir fait partie de la résilience en matière de sécurité ; un système conçu pour de telles conditions est également décrit comme capable de maintenir ou de rétablir ses fonctions malgré des défaillances. Cela ne prouve en aucun cas qu'un logiciel vulnérable est sûr, et ne remplace jamais le travail de correction et de vérification d'un défaut. [38]
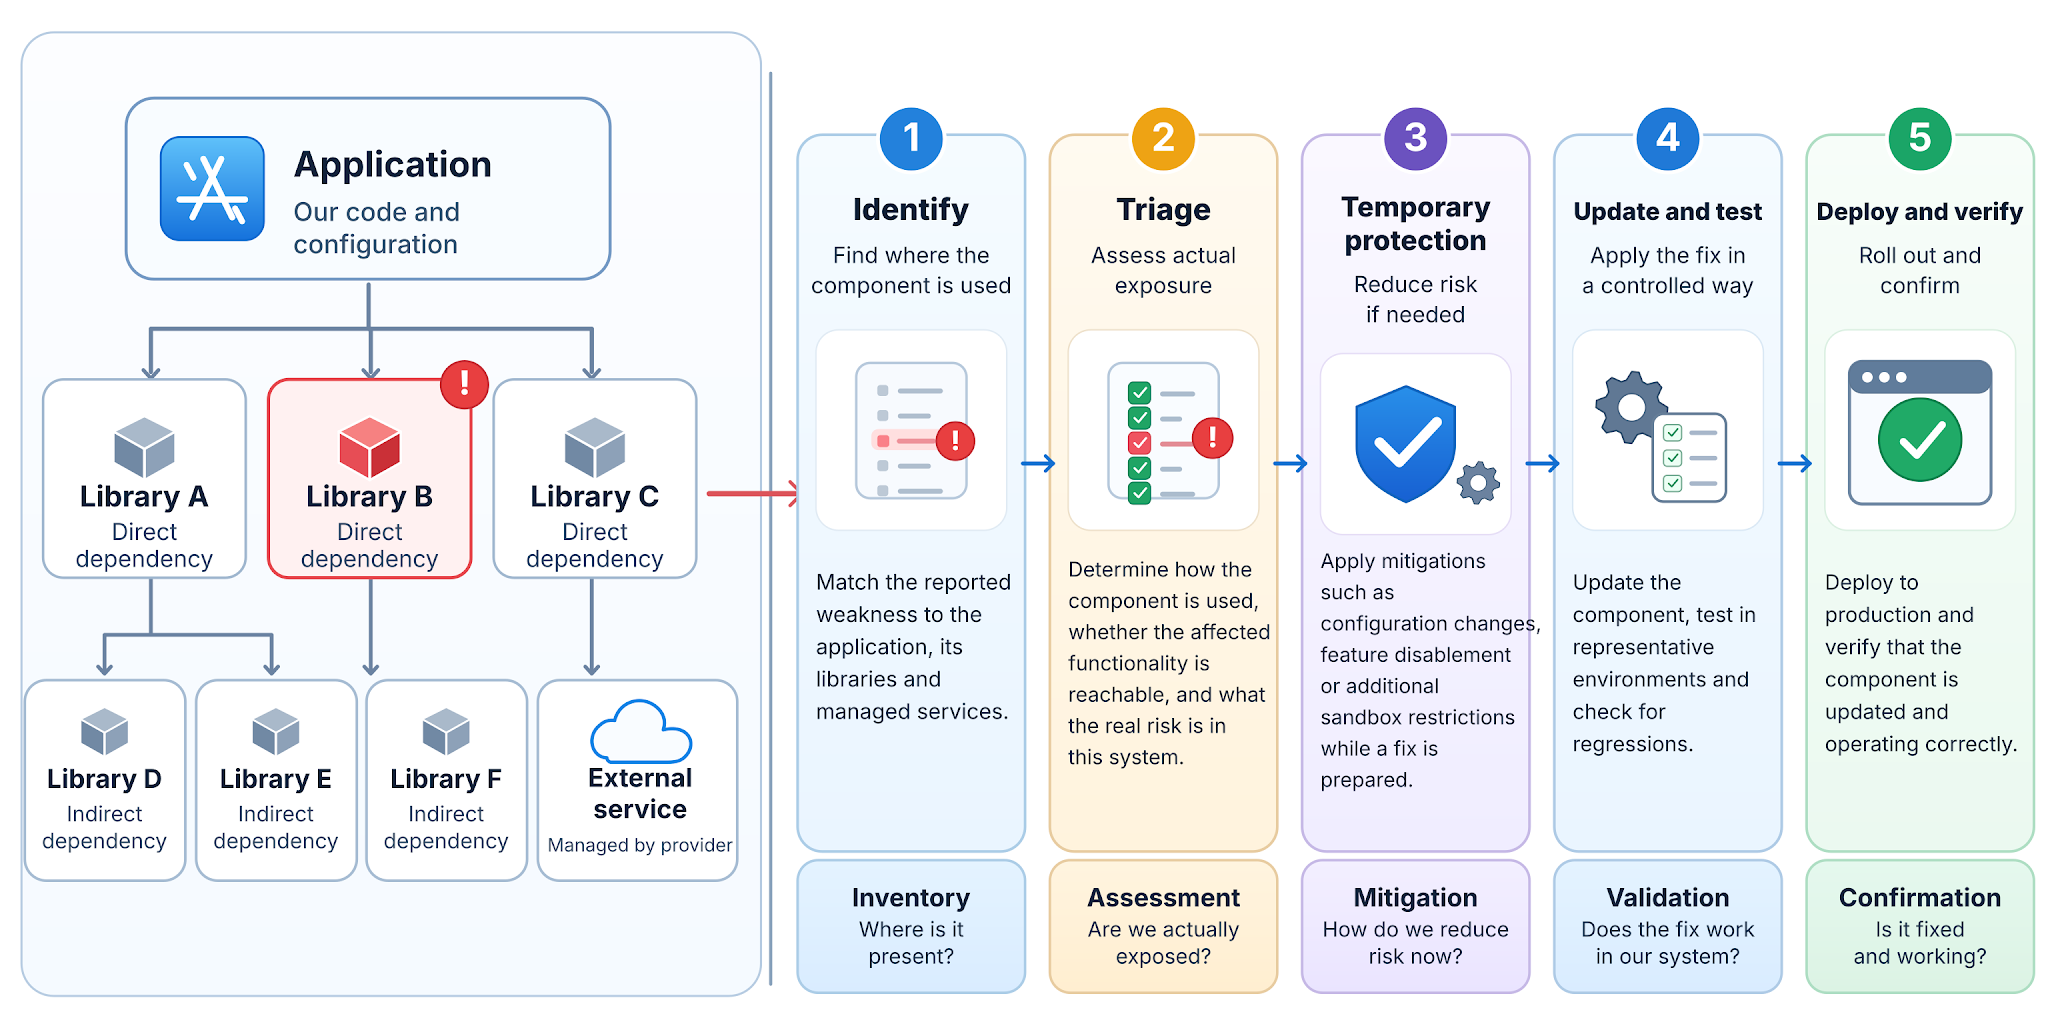
L’externalisation ne dispense pas de ces responsabilités. Un prestataire peut développer une application, exploiter un service cloud, gérer les appareils de travail ou maintenir un site web, mais l’organisation commanditaire reste responsable du niveau de risque qu’elle est prête à accepter. Certains prestataires sont très compétents et rigoureux ; d’autres dispersent leur attention sur un trop grand nombre de clients ou ne fournissent que peu de preuves de maintenance après la livraison initiale. La véritable faiblesse ne réside pas dans la simple présence d’un prestataire externe, mais dans un dispositif où personne ne peut identifier clairement les dépendances du système, approuver les accès, détecter les défauts, appliquer les modifications, valider les mises en production ni intervenir en cas de problème. Les contrats, les descriptions de services et les labels peuvent contribuer à définir les attentes, mais une maintenance observable et une responsabilité clairement établie sont plus importantes que de simples paroles rassurantes. [2]
Les logiciels libres offrent un système d'examen précieux, car leur code peut être inspecté et remis en question au-delà de l'équipe de développement initiale. Cependant, l'argument souvent avancé selon lequel de nombreuses personnes peuvent examiner le code ne garantit pas qu'un nombre suffisant de personnes qualifiées le fassent réellement, ni que les défauts signalés seront résolus rapidement. Les projets de logiciels libres vont des organisations bien financées aux petites équipes assurant la maintenance de composants largement utilisés ; les logiciels propriétaires varient également considérablement dans leurs méthodes d'examen et de maintenance. La mise à jour de sécurité de PHP d'octobre 2026 illustre cette distinction. Après avoir corrigé deux vulnérabilités critiques, la Fondation PHP a expliqué comment des compromis techniques difficiles, un nombre limité de mainteneurs expérimentés et son processus décisionnel avaient retardé la résolution d'un problème sous-jacent. Elle a également reconnu le rôle des ingénieurs financés et des chercheurs externes dans la finalisation des corrections. Les failles impliquaient une corruption de la mémoire après épuisement des ressources et un état interne obsolète entre les requêtes, établissant un lien entre les mécanismes de gestion de la mémoire et des erreurs évoqués précédemment et la maintenance spécialisée nécessaire à la réparation d'un environnement d'exécution largement utilisé. L'objectif n'est pas de dire que les logiciels libres sont intrinsèquement plus faibles, ni qu'un produit propriétaire est plus sûr. C’est la disponibilité du code source qui crée une opportunité d’examen, tandis qu’une expertise soutenue, une responsabilité claire et une maintenance efficace transforment les constats en protection. [73]
Il est également nécessaire de tester les logiciels dans les conditions d'utilisation prévues. Une démonstration réussie de la fonctionnalité principale ne renseigne que peu sur les conséquences d'une requête d'enregistrement par un compte incorrect, d'un conflit entre deux opérations, d'un fichier corrompu ou de la réception d'une commande inattendue par un assistant privilégié. La validation de sécurité vérifie la conformité des exigences définies avec la version et la configuration déployées. Elle peut combiner l'analyse du code et des dépendances avec des tests des opérations autorisées et interdites, ainsi que des procédures de récupération après incident. Les tests ne peuvent pas prouver l'absence de vulnérabilité, et un résultat de test obtenu sur l'ordinateur d'un développeur ne permet pas d'établir les restrictions d'un produit commercialisé. Inversement, l'absence d'audit public ne prouve pas l'insécurité d'un service. Les preuves crédibles précisent les éléments examinés, la version et la configuration utilisées, les résultats obtenus et les points restés incertains. [2]
Comment évaluer un avertissement de sécurité
Les médias ont souvent tendance à utiliser un vocabulaire alarmiste pour décrire plusieurs situations différentes. Une faiblesse est un défaut ou une anomalie susceptible d'entraîner des dommages dans certaines circonstances. Une vulnérabilité est une faiblesse qui peut être exploitée pour compromettre la sécurité ; une exploitation est une méthode permettant de l'utiliser. Affirmer qu'une faille permet l'exécution de code à distance signifie que, dans certaines conditions, un attaquant peut amener un logiciel à exécuter du code. Cela ne prouve pas, en soi, qu'une organisation a été attaquée ou que toutes ses données ont été dérobées. Une violation confirmée atteste d'un accès non autorisé ou d'un autre incident compromettant, même si l'étendue exacte des dégâts peut faire l'objet d'une enquête. Les niveaux de gravité, les démonstrations d'exploitation et les conclusions d'incident répondent à des questions différentes et ne doivent pas être considérés comme synonymes.
Un identifiant public de vulnérabilité, souvent noté CVE, permet à différentes organisations de discuter d'une même faille signalée. Il ne s'agit pas d'un registre exhaustif des installations affectées, ni d'une preuve d'exploitation réussie. Un score de gravité évalue les caractéristiques de la faille à l'aide d'un modèle de notation défini ; l'urgence opérationnelle dépend néanmoins de l'environnement et des ressources accessibles à un attaquant. Le terme « zero-day » est souvent utilisé pour désigner une faille exploitée avant la publication d'un correctif efficace ou avant même que le système de défense n'en ait connaissance, bien que les conventions de signalement varient. Son importance réside dans la faible marge de manœuvre du système de défense pour corriger la vulnérabilité en amont, et non dans le caractère mystérieux du terme. Une vulnérabilité vieille de plusieurs années, même pour laquelle un correctif a été publié, peut constituer une urgence immédiate si elle est exploitée sur des machines exposées qui n'ont jamais été mises à jour. [74] [75]
Le premier facteur permettant d'évaluer la gravité pratique d'une vulnérabilité est l'accessibilité. Un attaquant qui doit déjà avoir le contrôle physique d'une machine verrouillée se trouve dans une situation différente de celle d'un attaquant pouvant envoyer une requête à un service public. Une faille dans une fonctionnalité optionnelle rarement utilisée diffère de la même faille dans un service accessible via Internet, même si les deux peuvent nécessiter une correction. Le deuxième facteur est l'autorité : les conséquences dépendent de la capacité du code affecté à lire des informations publiques, accéder à des données privées, modifier des comptes, exécuter des commandes ou influencer un administrateur via un service délégué. Le troisième facteur est l'exposition et les preuves : la version affectée doit être effectivement présente, la voie vulnérable doit être utilisable dans des conditions pertinentes, et les signalements d'exploitation active ont une importance plus immédiate qu'une simple possibilité théorique. [1]
La remédiation est le quatrième facteur. Un fournisseur a peut-être déjà publié un correctif, un service l'a peut-être déployé, ou une organisation peut encore enquêter sur les systèmes affectés. Un correctif peut supprimer le défaut immédiat sans pour autant prouver que chaque système potentiellement compromis a été examiné. Si une exploitation a pu se produire avant le correctif, une enquête, des modifications d'identifiants et le rétablissement d'un état fiable peuvent également s'avérer nécessaires. Des déclarations crédibles permettent de distinguer une vulnérabilité découverte, une tentative d'attaque bloquée, un accès non autorisé confirmé et un dommage effectivement constaté. L'incertitude est normale lors d'un incident ; une certitude non étayée ne saurait remplacer les preuves. [65]
Ces distinctions facilitent également l'évaluation des affirmations de sécurité des fournisseurs et des sous-traitants. La preuve d'un inventaire des composants à jour, d'une responsabilité clairement définie en matière de correctifs, de tests de mise en production pertinents, d'un contrôle d'accès des privilèges et d'un processus de réponse aux incidents efficace est plus instructive qu'une promesse de sécurité absolue. Ces mêmes questions se posent, que le travail soit effectué par une grande entreprise technologique, une petite équipe de développement ou une agence externe. La taille de l'organisation n'est ni une preuve de compétence ni une preuve de négligence. Ce qui compte, c'est la capacité à identifier un problème, à expliquer son impact potentiel, à le corriger et à s'assurer que la correction est effective dans le système dont dépendent les utilisateurs. [2]
En résumé
La sécurité logicielle est complexe car une opération, même techniquement valide, peut se produire dans des conditions inappropriées. Un système peut accepter un mot de passe présenté par un imposteur, un service privilégié peut agir pour le compte d'un appelant non autorisé, une vérification peut devenir obsolète, des données malveillantes peuvent être interprétées comme du code, ou une faille de mémoire peut contourner une règle appliquée par ailleurs. Les dépendances, les processus de compilation, le micrologiciel et la maintenance multiplient les risques d'absence ou d'inefficacité des mesures de sécurité. Chaque défaillance ayant une cause différente, la fiabilité repose sur la compréhension du cheminement depuis l'influence de l'attaquant jusqu'à son impact.
Les déclarations de sécurité les plus utiles sont spécifiques. Elles identifient les éléments à protéger, les capacités des attaquants prises en compte, les actions possibles du composant affecté, les protections indépendantes et les preuves issues des tests de la configuration déployée. Elles expliquent également la surveillance des dépendances, le tri des vulnérabilités signalées, la limitation des risques lors de la préparation des mises à jour et la vérification du déploiement. La responsabilité de la mise en œuvre de ces protections incombe aux développeurs et aux opérateurs. Les utilisateurs du logiciel n'ont pas besoin d'être des experts en sécurité pour obtenir des réponses crédibles ; un label, un certificat ou une démonstration concluante suffisent.
Ce que vous devez savoir :
| N° | Terme | Définition |
|---|---|---|
| 1 | Surface d’attaque | Les points d'entrée, de saisie, d'action ou d'extraction d'informations d'un attaquant, y compris les services et interfaces exposés. |
| 2 | Authentification | Vérifier l'identité déclarée dans le respect des garanties de la méthode utilisée. |
| 3 | Autorisation | Vérifier si un acteur peut effectuer une action particulière sur une ressource particulière dans les conditions pertinentes. |
| 4 | Disponibilité | Un service restant utilisable dans les conditions pour lesquelles il a été conçu. |
| 5 | Étendue des conséquences | Les informations, les opérations ou autres ressources qu'une panne ou une compromission peut affecter, directement ou indirectement par l'intermédiaire d'autres composants. |
| 6 | Défaillance de la logique métier | Le non-respect de la séquence autorisée, des prérequis ou des limites d'une opération, même lorsque les requêtes individuelles sont bien formées et authentifiées. |
| 7 | Confidentialité | Les informations ne sont divulguées qu'aux destinataires autorisés. |
| 8 | Problème du « confused deputy » | Un composant plus puissant agissant indûment pour le compte d'un demandeur ne disposant pas de l'autorisation nécessaire. |
| 9 | Vulnérabilité de conception | Une faiblesse dans les règles, les autorisations, le protocole ou le flux de travail prévus d'un système, qui permet la violation d'une exigence de sécurité même lorsque le logiciel respecte cette conception. |
| 10 | Autorisation malgré l’échec du contrôle (fail-open) | Une défaillance de la gestion des erreurs dans laquelle un contrôle de sécurité indisponible ou ayant échoué est traité comme une autorisation de poursuivre. |
| 11 | Durcissement (renforcement de la sécurité) | Réduire l'exposition d'un système en désactivant les services et fonctionnalités inutiles, en limitant l'accès et les autorisations, et en vérifiant les paramètres déployés. |
| 12 | Implémentation | Le code et la configuration qui mettent en pratique une conception ou un protocole ; des contrôles de sécurité peuvent être absents même lorsque la conception est solide. |
| 13 | Vulnérabilité par injection | Faille permettant à des données externes de modifier le sens d’une commande, d’une requête ou d’un contenu interprété au lieu de rester de simples données. |
| 14 | Abus de privilèges en interne | L’utilisation abusive d’un accès légitimement accordé à une personne, y compris la divulgation ou les actions dépassant le cadre autorisé. |
| 15 | Intégrité | Protection contre toute modification non autorisée ou involontaire des informations ou de l'état du système. |
| 16 | Déplacement latéral | Un attaquant étendant son accès à partir d'un point d'entrée initial à d'autres comptes, services ou systèmes. |
| 17 | Principe du moindre privilège | Limiter l'accès et les opérations de chaque personne ou composante aux seules exigences de son travail, y compris les demandes adressées à d'autres services. |
| 18 | Memory Integrity Enforcement (MIE) | Les protections d'Apple sur les appareils compatibles combinent des contrôles matériels de la mémoire avec des restrictions logicielles et du système d'exploitation pour contrer certaines attaques par corruption de mémoire. |
| 19 | Sûreté de la mémoire | Prévention des opérations mémoire invalides, notamment les accès hors limites et l'utilisation de la mémoire au-delà de sa durée de vie valide. Des règles et des contrôles de sécurité garantissent la protection des données. |
| 20 | Configuration incorrecte | Un paramètre qui expose des données, des services, des autorisations ou des fonctionnalités au-delà de ce que requiert l'utilisation prévue d'un système, y compris des services inutiles laissés activés. |
| 21 | Authentification des pointeurs (PAC) | Vérification de pointeurs sélectionnés pour rendre plus difficiles certaines attaques par corruption de mémoire et par injection de contrôle de flux ; n’applique pas indépendamment les politiques du noyau. |
| 22 | Élévation de privilèges | Obtenir des autorisations ou une autorité d'exécution plus étendues après avoir exploité une faille, un identifiant ou une autre faiblesse. |
| 23 | Protocole | Les règles régissant l'échange de messages et les vérifications nécessaires entre systèmes interagissant, ainsi que la conception sécurisée et la mise en œuvre correcte de ces règles, sont des tâches distinctes. |
| 24 | Accessibilité de la fonction concernée | La capacité d'un attaquant à accéder à une opération affectée dans la configuration et les circonstances d'un déploiement réel. |
| 25 | Environnement isolé (sandbox) | Limites imposées par le système d'exploitation aux ressources auxquelles un processus peut accéder directement. Le processus peut néanmoins avoir des effets indirects via d'autres services. |
| 26 | Démarrage sécurisé | Suite de vérifications du démarrage visant à autoriser chaque étape suivante à partir d’une racine de confiance. |
| 27 | Secure Enclave | Un processeur de sécurité Apple distinct, doté de son propre micro-noyau, qui applique des règles pour certains secrets et opérations cryptographiques. |
| 28 | Contrôle de sécurité | Mécanisme ou procédure appliqué pour préserver une propriété de sécurité ou bloquer un chemin pouvant mener à un dommage. |
| 29 | Résilience en matière de sécurité | La capacité à résister aux défaillances de sécurité, à les contenir et à s'en remettre, tout en préservant ou en restaurant les services requis. |
| 30 | Triage de sécurité | Évaluation visant à déterminer si une vulnérabilité signalée affecte les logiciels déployés, est accessible, ce qu'elle pourrait permettre et avec quel degré d'urgence il convient d'y répondre. |
| 31 | Détournement de session | Utilisation d'un identifiant de session ou d'un jeton compromis pour effectuer des requêtes en tant que compte authentifié. |
| 32 | Ingénierie sociale | Utiliser la tromperie ou la manipulation pour obtenir des informations, accorder un accès ou réaliser des actions qui servent les intérêts de l'attaquant. |
| 33 | Nomenclature des composants logiciels (SBOM) | Un inventaire des composants logiciels et de leurs versions, y compris les dépendances, utilisé pour évaluer si un problème signalé est susceptible d'être présent. |
| 34 | Compromission de la chaîne d’approvisionnement logicielle | Modification malveillante d'une dépendance, d'une source, d'un processus de compilation, de publication ou de distribution afin que du code malveillant puisse atteindre les utilisateurs en aval. |
| 35 | Modèle de menace | Un exposé des éléments à protéger, de la manière dont un adversaire peut influencer le système, des résultats importants et des hypothèses sous-jacentes aux protections. |
| 36 | Écart entre vérification et utilisation (TOCTOU) | Un laps de temps durant lequel la ressource ou l'état concerné peut changer entre le moment de sa vérification et celui de son utilisation, invalidant ainsi la décision précédente. |
| 37 | Canal auxiliaire fondé sur le temps d’exécution | Fuite d'informations due à des différences mesurables dans le calendrier des opérations plutôt qu'au résultat attendu. |
| 38 | Entrées non fiables | Des informations dont les propriétés pertinentes n'ont pas été établies pour l'usage auquel elles sont destinées, qu'elles aient été fournies de manière malveillante ou innocemment. |
| 39 | Utilisation de mémoire après libération (use-after-free) | Accès au stockage via une référence après la libération de l'objet d'origine, parfois après la réutilisation de cette mémoire. |
| 40 | Validation | Vérifier si une entrée, une requête, une opération ou un système satisfait aux exigences définies dans les conditions évaluées. |
Références
Les sources numérotées sont citées dans le texte. « s.d. » indique l’absence de date de publication.
- National Institute of Standards and Technology (2012). Guide for Conducting Risk Assessments. NIST Special Publication 800-30 Rev. 1. DOI: 10.6028/NIST.SP.800-30r1.
- National Institute of Standards and Technology (2022). Secure Software Development Framework (SSDF) Version 1.1: Recommendations for Mitigating the Risk of Software Vulnerabilities. NIST Special Publication 800-218. DOI: 10.6028/NIST.SP.800-218.
- OWASP Foundation (n.d.). Authentication Cheat Sheet. OWASP Cheat Sheet Series.
- Cybersecurity and Infrastructure Security Agency and Federal Bureau of Investigation (2025). Product Security Bad Practices: Updated Guidance. CISA/FBI advisory, 17 January 2025.
- OWASP Foundation (n.d.). Session Management Cheat Sheet. OWASP Cheat Sheet Series.
- Zhuo, S., Biddle, R., Koh, Y. S., Lottridge, D. and Russello, G. (2023). SoK: Human-centered Phishing Susceptibility. ACM Transactions on Privacy and Security, 26(3), Article 24. DOI: 10.1145/3575797.
- OWASP Foundation (n.d.). Authorization Cheat Sheet. OWASP Cheat Sheet Series.
- Hardy, N. (1988). The Confused Deputy (or Why Capabilities Might Have Been Invented). ACM SIGOPS Operating Systems Review, 22(4), pp. 36–38. DOI: 10.1145/54289.871709.
- OWASP Foundation (n.d.). Authorization Patterns Cheat Sheet. OWASP Cheat Sheet Series.
- The Chromium Project (n.d.). Sandbox Design. Chromium design documentation.
- National Institute of Standards and Technology (n.d.). Insider Threat. NIST CSRC Glossary.
- OWASP Foundation (n.d.). Business Logic Security Cheat Sheet. OWASP Cheat Sheet Series.
- MITRE (n.d.). CWE-367: Time-of-check Time-of-use (TOCTOU) Race Condition. Common Weakness Enumeration.
- OWASP Foundation (n.d.). Input Validation Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). SQL Injection Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- OWASP Foundation (n.d.). Cross Site Scripting Prevention Cheat Sheet. OWASP Cheat Sheet Series.
- The Rust Project (n.d.). The Rust Programming Language: References and Borrowing; Unsafe Rust. Rust language documentation.
- The Swift Project (n.d.). Memory Safety. The Swift Programming Language, Swift.org.
- Python Software Foundation (n.d.). Extending and Embedding the Python Interpreter. Python 3 documentation.
- Szekeres, L., Payer, M., Wei, T. and Song, D. (2013). SoK: Eternal War in Memory. IEEE Symposium on Security and Privacy, pp. 48–62. DOI: 10.1109/SP.2013.13.
- Anderson, R. (1993). Why Cryptosystems Fail. Proceedings of the 1st ACM Conference on Computer and Communications Security, pp. 215–227. DOI: 10.1145/168588.168615.
- Internet Engineering Task Force (2023). Service Identity in TLS. RFC 9525.
- Internet Engineering Task Force (2020). JSON Web Token Best Current Practices. RFC 8725.
- Rescorla, E. (2018). The Transport Layer Security (TLS) Protocol Version 1.3. IETF RFC 8446. DOI: 10.17487/RFC8446.
- Clark, J. and van Oorschot, P. C. (2013). SoK: SSL and HTTPS: Revisiting Past Challenges and Evaluating Certificate Trust Model Enhancements. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP.2013.41.
- National Institute of Standards and Technology (n.d.). Side Channel. NIST CSRC Glossary.
- Anderson, R. and Needham, R. (1995). Programming Satan's Computer. In Computer Science Today, pp. 426–440. DOI: 10.1007/BFB0015258.
- Kim, Y., et al. (2014). Flipping Bits in Memory Without Accessing Them: An Experimental Study of DRAM Disturbance Errors. Proceedings of the 41st International Symposium on Computer Architecture, pp. 361–372. DOI: 10.1109/ISCA.2014.6853210.
- Seaborn, M. and Dullien, T. (2015). Exploiting the DRAM Rowhammer Bug to Gain Kernel Privileges. Google Project Zero research, March 2015.
- Kocher, P., et al. (2018). Spectre Attacks: Exploiting Speculative Execution. arXiv:1801.01203, security research preprint.
- Lipp, M., et al. (2018). Meltdown: Reading Kernel Memory from User Space. 27th USENIX Security Symposium.
- Intel (n.d.). Analysis of Speculative Execution Side Channels. Intel Software Security Guidance.
- NVIDIA (2018). Security Notice: NVIDIA Tegra RCM Vulnerability. NVIDIA Product Security Notice, 24 April 2018.
- Temkin, K. and ReSwitched (2018). Fusée Gelée: Boot ROM Vulnerability Disclosure. Research disclosure.
- National Institute of Standards and Technology (2018). Platform Firmware Resiliency Guidelines. NIST Special Publication 800-193. DOI: 10.6028/NIST.SP.800-193.
- Glosner, C. and Machiry, A. (2026). SoK: All You Ever Wanted to Know About Bootloader Security but Were Afraid to Ask. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP63933.2026.00163.
- Lefeuvre, H., Dautenhahn, N., Chisnall, D. and Olivier, P. (2025). SoK: Software Compartmentalization. IEEE Symposium on Security and Privacy. DOI: 10.1109/SP61157.2025.00075.
- Ross, R., Pillitteri, V., Graubart, R., Bodeau, D. and McQuaid, R. (2021). Developing Cyber-Resilient Systems: A Systems Security Engineering Approach. NIST Special Publication 800-160, Vol. 2 Rev. 1. DOI: 10.6028/NIST.SP.800-160v2r1.
- Apple (n.d.). Operating System Integrity. Apple Platform Security.
- Apple Security Research (2025). Memory Integrity Enforcement: A Complete Vision for Memory Safety in Apple Devices. Apple Security Research technical blog.
- Apple (n.d.). Secure Enclave. Apple Platform Security.
- Apple Developer (n.d.). Protecting Keys with the Secure Enclave. Apple Developer Documentation, Security.
- Microsoft (n.d.). Trusted Platform Module (TPM) fundamentals. Microsoft Learn.
- Arm (n.d.). TrustZone for Cortex-A. Arm Technologies.
- Intel (n.d.). Intel Software Guard Extensions SDK for Linux OS. Intel Developer Documentation.
- Zinkus, M., Jois, T. M. and Green, M. (2022). SoK: Cryptographic Confidentiality of Data on Mobile Devices. Proceedings on Privacy Enhancing Technologies, 2022(1), pp. 586–607. DOI: 10.2478/popets-2022-0029.
- Apple Developer (n.d.). Enabling Enhanced Security for Your App. Apple Developer Documentation, Xcode.
- Apple Developer (n.d.). Preparing Your App to Work with Pointer Authentication. Apple Developer Documentation, Security.
- LLVM Project (n.d.). Pointer Authentication. Clang Compiler Documentation.
- OWASP Foundation (2025). A10: Mishandling of Exceptional Conditions. OWASP Top 10: 2025.
- MITRE (n.d.). Privilege Escalation (TA0004). MITRE ATT&CK knowledge base.
- MITRE (n.d.). Lateral Movement (TA0008). MITRE ATT&CK knowledge base.
- OWASP Foundation (2025). A03: Software Supply Chain Failures. OWASP Top 10: 2025.
- Cybersecurity and Infrastructure Security Agency and international partners (2026). 2026 Minimum Elements for a Software Bill of Materials (SBOM). Joint government guidance.
- Abu Ishgair, E., Gomez, J., Melara, M. S., Cárdenas, A. A. and Torres-Arias, S. (2026). SoK: A Defense-Oriented Evaluation of Software Supply Chain Security. IEEE European Symposium on Security and Privacy, pp. 836–859. DOI: 10.1109/EuroSP68448.2026.00059.
- Boyens, J., et al. (2024). Cybersecurity Supply Chain Risk Management Practices for Systems and Organizations. NIST SP 800-161 Rev. 1, Update 1.
- Arasaratnam, O., et al. (2024). xz Backdoor CVE-2024-3094. Open Source Security Foundation, 30 March 2024.
- Cox, R. (2024). Timeline of the xz Open Source Attack. Research note, 2024.
- Supply-chain Levels for Software Artifacts (n.d.). Provenance. SLSA Specification, version 1.2.
- Supply-chain Levels for Software Artifacts (n.d.). Build: Verifying Artifacts. SLSA Specification, version 1.2.
- The Update Framework (2024). Overview. TUF Documentation, last updated October 2024.
- Rekhi, S., Amberiadis, K., Akib, A. A., and Srivastava, A. (2025). Analyzing Collusion Threats in the Semiconductor Supply Chain. NIST Cybersecurity White Paper 46. DOI: 10.6028/NIST.CSWP.46.
- National Institute of Standards and Technology (n.d.). Supply Chain. NIST Mobile Threat Catalogue.
- Cybersecurity and Infrastructure Security Agency (n.d.). Known Exploited Vulnerabilities Catalog. CISA vulnerability catalogue.
- UK National Cyber Security Centre (n.d.). Vulnerability Management: Carry Out Assessments. NCSC vulnerability management guidance.
- Charrier, C., and Semrau, J. (2023). Analysis of Time-to-Exploit Trends: 2021–2022. Mandiant / Google Threat Intelligence, 28 September 2023.
- Charrier, C., and Weiner, R. (2024). How Low Can You Go? An Analysis of 2023 Time-to-Exploit Trends. Mandiant / Google Threat Intelligence, 15 October 2024.
- Mandiant (2026). M-Trends 2026: Data, Insights, and Strategies From the Frontlines. Google Threat Intelligence.
- Fang, R., Bindu, R., Gupta, A., and Kang, D. (2024). LLM Agents Can Autonomously Exploit One-Day Vulnerabilities. arXiv preprint 2404.08144.
- Grunewald, R., Mazumdar, S., and Vanderlee, K. (2026). Vulnerability Discovery and Exploitation Trends in the AI Era. Google Threat Intelligence Group, 1 October 2026.
- UK AI Security Institute (2026). How Far Behind the Frontier Are Leading Open-Weight Models on Cyber? AISI Work.
- International AI Safety Report (2026). International AI Safety Report 2026. Section 3.4, Open-weight models.
- The PHP Foundation (2026). Today's PHP Security Release, and How We're Strengthening PHP Security. The PHP Foundation Blog, 21 October 2026.
- CVE Program (n.d.). Common Vulnerabilities and Exposures: CVE Program Mission and Records. CVE Program.
- FIRST (n.d.). Common Vulnerability Scoring System (CVSS) v4.0: User Guide. FIRST.org, document version 1.2.